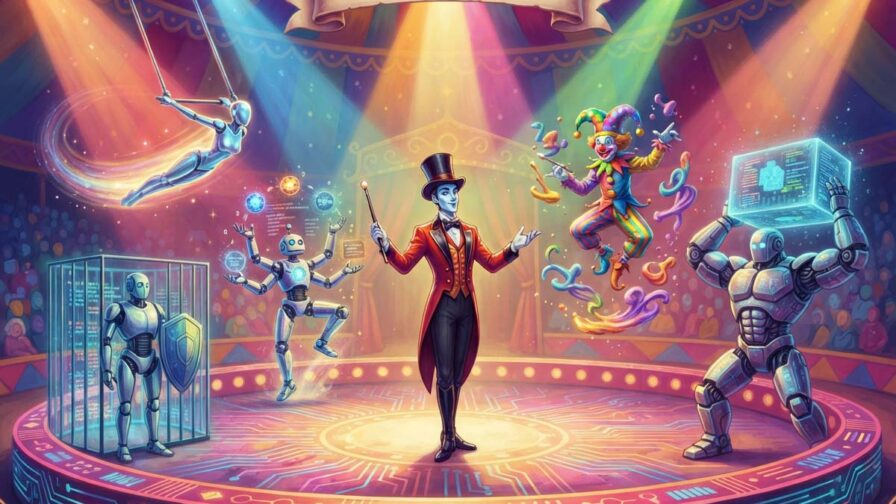
Durante mucho tiempo, la carrera por la inteligencia artificial ha parecido bastante sencilla: cada laboratorio intentaba desarrollar el modelo más grande, más caro y más potente del mercado. Pero, cuando llevamos estos modelos a situaciones reales, nos encontramos con un problema: muchas veces estamos utilizando una herramienta demasiado potente para tareas que no necesitan tanto. Por ejemplo, resumir una nota, sacar una fecha de un documento, preparar un primer borrador o hacer un cambio repetitivo en un archivo de código.
Por eso, el cambio que estamos viendo estos últimos meses no consiste solo en crear modelos de lenguaje cada vez más avanzados. Se trata de desarrollar sistemas capaces de decidir, en cada momento, qué modelo, agente o herramienta utilizar y cuándo es mejor parar, comprobar los resultados o pedir ayuda a una persona.
Andrew Ng, uno de los referentes más conocidos del sector, lleva tiempo señalando cuatro patrones fundamentales de los llamados workflows agénticos: la reflexión, el uso de herramientas, la planificación y la colaboración entre varios agentes. Los cuatro tienen algo en común: el modelo ya no tiene que dar una respuesta definitiva en un único intento.
De dónde viene todo esto
Este artículo continúa una línea de reflexión que ya habíamos empezado en Codemotion. En el primero, dedicado al task switching, hablaba de cómo, para la mayoría de las tareas del día a día, no necesitamos utilizar siempre el modelo más reciente. También explicaba cómo organizar las herramientas por niveles, desde los modelos más avanzados hasta los modelos locales y gratuitos, nos permite elegir la opción más adecuada para cada tarea, en lugar de estar pendientes de cada nuevo lanzamiento.
Más recientemente, en mi portal, publiqué un segundo artículo sobre cómo Opus 5 superó a Fable 5. En este caso, aquella idea teórica empezó a verse reflejada en los datos: ante un modelo de primer nivel más caro y con ciertas limitaciones, las empresas empezaron a trasladar parte de su inversión a alternativas más económicas, reservando los modelos más potentes para las tareas que realmente los necesitan.
El siguiente paso es preguntarnos qué ocurre cuando no cambiamos de modelo una sola vez al principio de una conversación, sino que construimos un sistema capaz de repartir el trabajo durante todo el proceso. Es decir, un sistema que asigna automáticamente diferentes funciones a distintos modelos y herramientas, sin que una persona tenga que elegir cada vez qué utilizar desde un menú desplegable.
Qué significa realmente el switching
En su forma más sencilla, el switching es la selección del modelo (model selection): elegir cuál es el más adecuado antes incluso de empezar a procesar una petición.
En una versión más avanzada, hablamos de routing. Aquí el sistema utiliza información sobre la petición, el ámbito, el nivel de riesgo o el coste previsto para decidir qué camino debe seguir cada tarea.
En una versión todavía más dinámica, encontramos el cascade o sistema en cascada. En este caso, se intenta resolver primero el problema con un modelo económico y solo se recurre a otro más potente si el resultado no es suficiente.
Por último, cuando hablamos de agentes, el switching se convierte en delegation o delegación. La tarea se divide en diferentes partes y se asigna a distintos roles, que pueden tener modelos, herramientas y permisos diferentes.
Veamos un ejemplo práctico. Una consulta de atención al cliente sobre el estado de un envío puede resolverse en pocos segundos con un modelo económico. Sin embargo, una reclamación que implique una devolución de mucho dinero o un posible problema legal necesitará un modelo más avanzado, acceso a documentación adicional y, probablemente, una revisión humana antes de cerrar el caso.
Del modelo único a un sistema formado por varias piezas
Podemos entender este cambio con una comparación bastante sencilla.
Un modelo único sería como tener a un profesional excepcional al que le pedimos que se encargue de absolutamente todo, desde las tareas administrativas más aburridas hasta los diagnósticos más complejos.
Un sistema orquestado, en cambio, se parece más a una redacción o a un equipo de desarrollo. Cada tarea se asigna a quien mejor puede resolverla, teniendo en cuenta sus conocimientos, el coste, las herramientas disponibles y el nivel de responsabilidad que requiere.
Hay algo importante que debemos tener claro: esto no significa necesariamente que estemos creando una inteligencia artificial «más inteligente» si nos fijamos únicamente en el modelo de lenguaje. Puede que, sencillamente, estemos construyendo un sistema más eficiente porque aprovecha mejor los recursos que tiene disponibles.
Por ejemplo, un modelo pequeño o rápido puede encargarse de seleccionar información, extraer datos, clasificar contenidos y preparar primeros borradores. Un modelo de última generación puede intervenir únicamente cuando haga falta planificar, resolver situaciones ambiguas, tomar decisiones importantes o realizar una revisión final.
También podemos recurrir a herramientas externas que no son modelos de lenguaje, sino programas informáticos capaces de comprobar datos, ejecutar pruebas o consultar bases de datos con una precisión que ningún LLM puede garantizar por sí solo.
Routing, cascada y delegación: las principales técnicas
El router es, en cierto modo, el recepcionista del sistema. Recibe una petición y analiza de qué tipo es y qué dificultad tiene. ¿Es una pregunta corta o larga? ¿Necesita conocimientos generales o un razonamiento más elaborado? ¿Implica poco o mucho riesgo? ¿Necesita herramientas externas?
Para tomar esta decisión puede utilizar reglas concretas definidas por quienes diseñan el sistema, un clasificador específico, otro modelo de lenguaje que actúe como árbitro o un sistema entrenado con datos que calcule la relación entre calidad y coste de cada modelo disponible.
Sin embargo, el router también puede equivocarse. Si calcula que una tarea es más sencilla de lo que realmente es, puede enviarla a un modelo que no esté preparado para resolverla y generar un resultado de poca calidad. Por el contrario, si considera que todas las tareas son complejas por precaución, acaba enviándolas al modelo más caro y pierde toda la ventaja económica. En ese caso, el sistema deja de tener sentido.
El funcionamiento de la cascada es algo diferente.
En el routing tradicional, el sistema toma una decisión antes de generar cualquier respuesta: «Esta pregunta va al modelo A».
En un sistema en cascada, primero se genera una respuesta con un modelo económico y, después, se comprueba si es suficiente. Si no lo es, se corrige, se vuelve a generar, se envía a un revisor o se pasa a un modelo más caro.
El principal reto aquí está en saber medir la calidad de la respuesta. El sistema puede utilizar puntuaciones de confianza, evaluadores específicos, pruebas automáticas, comparaciones entre varias respuestas o un segundo modelo que actúe como juez.
Pero este último también puede equivocarse, compartir los mismos sesgos que el modelo que ha generado la respuesta o dar más valor a una respuesta convincente que a una respuesta realmente correcta.
Un paso más allá es dividir el problema en diferentes tareas.
Muchos de los trabajos que hacemos en el mundo real no tienen una única respuesta. Suelen implicar una cadena de acciones: entender el objetivo, buscar fuentes, leer documentos, comparar opciones, hacer cálculos o ejecutar código, comprobar que se cumplen ciertos requisitos, preparar un resultado y, finalmente, revisarlo.
Un agente planner puede encargarse de crear un plan con todas esas subtareas y asignar cada una a quien corresponda. Por ejemplo:
- Búsqueda de información: a un agente con acceso a un navegador o a una base de datos.
- Cálculos y operaciones numéricas: a un entorno Python.
- Redacción de tareas repetitivas: a un modelo rápido.
- Razonamientos más complejos: a un modelo más potente.
- Aprobación final: a una persona.
Eso sí, hay algo importante que debemos tener en cuenta: dividir una tarea no siempre es mejor. Si el trabajo no se puede separar realmente en partes independientes, fragmentarlo puede hacer que se pierda información, añadir pasos innecesarios y complicar la tarea de identificar dónde se ha producido un error.
Anthropic ha recogido varios de estos patrones en su guía «Building effective agents». En ella define el modelo orchestrator-workers como un sistema central que divide dinámicamente una tarea, delega las distintas partes en otros modelos y reúne los resultados para crear una respuesta final.
Este enfoque resulta especialmente útil en problemas complejos en los que no podemos saber de antemano qué subtareas serán necesarias. Un ejemplo habitual es trabajar con proyectos de código que afectan a varios archivos.
El último nivel es la verdadera orquestación multiagente. Aquí ya no hablamos únicamente de elegir modelos, sino de organizar todo el proceso: los roles, el orden de las acciones, las herramientas disponibles, la memoria compartida, los controles, los permisos, la gestión de errores, las condiciones para detenerse y quién asume la responsabilidad final si algo sale mal.
El caso de Astra Flash Orchestrator
Un ejemplo práctico nos ayuda a entender mejor todo esto.
El repositorio astra-flash-orchestrator, publicado por el desarrollador Ethan+ (autor también de otros proyectos relacionados con agentes, como el asistente de voz Jarvis para Claude Code), está diseñado como un flujo de trabajo nativo para Codex, el entorno de programación basado en agentes de OpenAI.
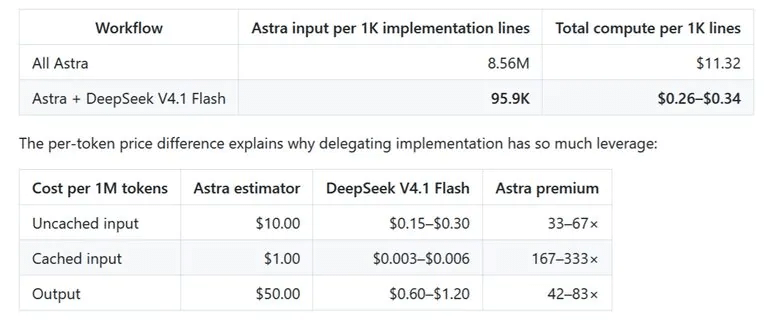
La idea es que Astra se encargue de la planificación, la arquitectura y la revisión final, mientras que DeepSeek V4.1 Flash, un modelo bastante más económico, asume la implementación, las pruebas y las tareas habituales de depuración.
El funcionamiento, tal y como lo explica su creador en un debate público sobre el repositorio de Codex, es bastante fácil de seguir.
Cuando recibe un objetivo complejo, Astra interpreta la petición, define su alcance y establece los criterios que debe cumplir el resultado. Después, DeepSeek Flash se encarga de la implementación: revisa el código existente, escribe los cambios, ejecuta las pruebas y soluciona los problemas habituales que aparecen durante el proceso.
Por último, Astra revisa las modificaciones realizadas, comprueba que todo encaja con el plan inicial y decide si acepta el trabajo o si lo devuelve para hacer otra ronda de cambios.
En este proceso encontramos varias fases:
- Planificación y división de tareas: Astra analiza el objetivo y lo divide en partes más pequeñas.
- Delegación: las tareas se asignan a un modelo más económico que se encarga del trabajo práctico.
- Comprobaciones automáticas: las pruebas ofrecen información externa sobre el resultado, algo más fiable que limitarse a preguntar al propio modelo si ha hecho bien su trabajo.
- Corrección: si algo falla, el trabajo vuelve al modelo encargado de implementarlo para que realice los cambios necesarios.
Es decir, no se trata de generar una respuesta de una sola vez, sino de trabajar mediante diferentes fases de revisión y mejora.
Lo interesante no son tanto los nombres de los modelos utilizados, que probablemente cambiarán por otros en poco tiempo. Lo importante es que este ejemplo muestra de forma muy clara cómo un sistema puede reservar el modelo más caro para las tareas que necesitan criterio y responsabilidad, mientras deja el trabajo más repetitivo y de mayor volumen en manos de un modelo mucho más económico.
Astra actúa como supervisor y Flash genera buena parte del trabajo operativo. Es una distribución desigual de las responsabilidades y de la capacidad de decisión, no simplemente sustituir un modelo caro por otro barato.
La promesa del ahorro y lo que realmente demuestra
Aquí merece la pena adoptar una postura un poco más crítica. En el debate original de GitHub, el autor cuenta que consiguió reducir el uso de Astra aproximadamente un 94 % durante una sesión de desarrollo de 23 horas.
Por otro lado, un análisis posterior del proyecto publicado por RuntimeWire habla de una reducción de hasta el 98,9 % de los tokens de entrada consumidos por Astra por cada mil líneas de código implementadas y probadas. Sin embargo, esta cifra se basa en una única comparación realizada en local, no en un benchmark controlado.
Son dos cifras diferentes, obtenidas de formas distintas, y hay que interpretarlas como tal: son datos compartidos por el propio autor del proyecto, no resultados de una evaluación independiente que podamos aplicar a cualquier tipo de trabajo.
¿Qué debería incluir entonces un benchmark realmente útil? Para empezar, tendría que especificar los modelos utilizados, sus versiones, precios y la fecha en la que se realizó la medición. También debería detallar el tipo de repositorios analizados, su tamaño y nivel de dificultad; el número de tareas realizadas; la tasa de éxito y qué se considera exactamente un resultado de la misma calidad.
Además, habría que contabilizar los tokens generados por todos los agentes implicados, no solo los del modelo premium que estamos evaluando. También sería necesario tener en cuenta el coste de los errores: nuevos intentos, correcciones, información adicional necesaria y tiempo que una persona ha tenido que dedicar a solucionar los problemas.
Y no podemos olvidarnos de otros aspectos importantes, como el tiempo total que tarda el proceso (no solo los tokens que conseguimos ahorrar sobre el papel), la frecuencia de errores que pasan desapercibidos y su gravedad, o las situaciones concretas en las que este sistema de delegación ofrece peores resultados que utilizar directamente el modelo más avanzado, sin intermediarios.
También hay otro detalle que no debemos pasar por alto: en el momento de publicar este artículo, el repositorio todavía no cuenta con versiones oficiales publicadas. Esto apunta a que estamos ante un proyecto joven y experimental, más que ante una herramienta madura y preparada para utilizarse en entornos de producción.
Y hay algo que conviene dejar claro: ahorrar tokens del modelo premium no significa automáticamente ahorrar dinero, tiempo o reducir los riesgos del proceso en su conjunto.automáticamente ahorrar dinero, tiempo o reducir los riesgos del proceso en su conjunto.
Screenshot del repositorio oficial en GitHub
Verificar es tan complicado como delegar
Hay un videojuego independiente, Return of the Obra Dinn, en el que el jugador tiene que reconstruir qué les ha ocurrido a todos los miembros de una tripulación a partir de pequeñas pistas que pueden resultar ambiguas: una imagen congelada, una frase escuchada a medias o un detalle en la posición de los cuerpos.
El juego solo confirma que una deducción es correcta cuando se han acertado al menos tres hechos relacionados entre sí, no uno por uno.
Puede parecer una comparación un poco extraña, pero tiene bastante sentido para entender uno de los principales problemas de la orquestación. Un sistema de delegación solo funciona si tiene una forma fiable de saber cuándo el resultado de un agente es realmente correcto. Y esa comprobación casi nunca puede depender de una única señal aislada. Hay que combinar varias pistas, igual que en el videojuego. De lo contrario, corremos el riesgo de dar por buena una respuesta que parece coherente, pero que en realidad no lo es.
En el desarrollo de software contamos con algunas señales bastante fiables: que el proyecto se compile correctamente, que pasen las pruebas unitarias y de integración, los análisis estáticos, las comprobaciones de código (linting), los benchmarks o una revisión de los cambios realizados por una persona o por otro modelo.
Pero incluso en estos casos, que todas las pruebas funcionen no significa automáticamente que el cambio sea correcto, seguro y coherente con lo que quería conseguir el producto. Al fin y al cabo, las pruebas las ha escrito alguien y esa persona puede haber dejado fuera precisamente los casos límite más complicados.
En tareas editoriales, de investigación, legales o médicas, comprobar los resultados es mucho más difícil. Un texto bien escrito puede parecer totalmente convincente y, aun así, contener fuentes incorrectas, citas inventadas o conclusiones que no están justificadas por la información original.
Hay que decirlo claramente: la orquestación no elimina el problema de la fiabilidad del sistema. Simplemente lo traslada de la generación de respuestas al diseño de los mecanismos de control. Y eso es un problema diferente, pero no necesariamente más fácil de resolver.
No es un caso aislado
El caso de Astra Flash forma parte de una tendencia mucho más amplia y cada vez más visible en la industria. Las plataformas ya no se limitan a incorporar modelos cada vez más grandes. También están desarrollando herramientas para combinar agentes, hacer que se comuniquen entre sí, asignarles diferentes herramientas y conseguir que trabajen de forma coordinada mediante flujos de trabajo compartidos.
Una señal clara de este cambio es la aparición de protocolos específicos para facilitar la interoperabilidad.
En abril de 2025, Google presentó el Agent2Agent Protocol, conocido como A2A, pensado para que agentes desarrollados con diferentes plataformas o frameworks puedan comunicarse, intercambiar información y coordinar acciones entre ellos.
Dos meses después, en junio, Google donó el protocolo a la Linux Foundation, con el apoyo de empresas como AWS, Cisco, Salesforce, SAP y ServiceNow.
Este paso es más importante de lo que parece. Demuestra que la conversación está dejando de centrarse únicamente en agentes independientes, creados por un único proveedor, para empezar a abordar la compatibilidad entre sistemas completos de agentes desarrollados por empresas diferentes.
Eso no significa que el problema de la delegación esté resuelto. Más bien, indica que la interoperabilidad y la coordinación ya se consideran problemas importantes de infraestructura, y no simples experimentos para presentar en conferencias.
Las opiniones que importan
Anthropic defiende un enfoque bastante práctico en su guía sobre cómo construir agentes: empezar por la solución más sencilla posible e incorporar agentes, sistemas de routing y más autonomía únicamente cuando las mejoras obtenidas justifican la complejidad añadida.
Según su planteamiento, el modelo orchestrator-workers resulta especialmente útil cuando no podemos anticipar qué subtareas serán necesarias, como ocurre a menudo en proyectos de desarrollo que afectan a varios archivos al mismo tiempo.
Por su parte, Andrew Ng identifica la reflexión (reflection), el uso de herramientas (tool use), la planificación (planning) y la colaboración entre varios agentes como algunos de los patrones fundamentales del llamado diseño agéntico.
Su punto de vista es interesante porque vuelve a poner el diseño del flujo de trabajo en el centro de la conversación. Muchas veces, la mejora real no viene únicamente del último modelo disponible en el mercado, sino de cómo el sistema planifica, actúa, recibe información externa y corrige sus propios resultados.
OpenAI, en su propia guía práctica sobre la optimización de agentes, recomienda medir primero el punto de partida antes de introducir cambios y avanzar poco a poco.
Entre sus recomendaciones encontramos:
- Mejorar la información que recibe el modelo y evitar pasarle contexto innecesario.
- Revisar qué herramientas tiene disponibles.
- Enviar las tareas más sencillas a modelos más pequeños.
- Utilizar caché para las instrucciones (prompts) que se repiten.
- Separar las tareas que necesitan una respuesta inmediata de aquellas que pueden ejecutarse de forma asíncrona.
- Hacer un seguimiento continuo y evaluar los resultados de manera sistemática.
La guía también advierte, aunque de forma indirecta, sobre los riesgos de utilizar el routing sin criterio. Demasiadas reglas y pasos de asignación pueden añadir trabajo innecesario cuando, en realidad, la tarea inicial ya era bastante sencilla.
La conclusión es bastante clara: ninguna de estas fuentes defiende seriamente que multiplicar el número de agentes sea siempre una buena idea. Más bien coinciden en un principio mucho más razonable: añadir complejidad solo cuando las mediciones demuestren que realmente mejora el resultado.
Dónde tiene sentido esta arquitectura y dónde no
Que la orquestación merezca la pena depende de lo repetible y medible que sea una tarea y de si contamos con mecanismos claros para comprobar sus resultados.
En atención al cliente, por ejemplo, podemos delegar bastante bien la clasificación de consultas, la búsqueda de respuestas en una base de conocimiento y la preparación de primeros borradores. Sin embargo, las reclamaciones complejas, las excepciones y las devoluciones de grandes cantidades de dinero deberían seguir pasando por una persona.
En desarrollo de software, la búsqueda dentro de un repositorio, los cambios repetitivos, las pruebas y las comprobaciones de código son buenas candidatas para la delegación. En cambio, las decisiones de arquitectura, las migraciones importantes y las revisiones de seguridad deberían quedar en manos del modelo más avanzado o, mejor todavía, de una persona.
En la investigación editorial, que es precisamente el tipo de trabajo que hay detrás de este artículo y de muchos otros que escribo, también podemos delegar algunas tareas. Por ejemplo, extraer información de documentos, agrupar fuentes similares o preparar un primer resumen puede encargarse a un modelo más económico.
Pero seleccionar fuentes fiables, comprobar las citas y elaborar una opinión propia debería seguir bajo supervisión humana directa. Al final, es ahí donde nos jugamos la credibilidad del artículo.
El coste oculto de coordinarlo todo
Cada agente o paso que añadimos a un flujo de trabajo implica más llamadas, más tokens consumidos y, posiblemente, más tiempo de espera.
También supone más información que transferir o resumir entre las distintas partes del sistema, más posibilidades de que un error inicial se propague sin que nadie lo detecte y más dificultades para reproducir y entender qué ha fallado cuando algo sale mal.
A esto hay que sumar más credenciales, herramientas, permisos y posibles puntos de entrada para ataques que debemos controlar. Y también resulta más complicado reconstruir después qué modelo o agente tomó realmente una determinada decisión.
Toda esa eficiencia que parece tan evidente sobre el papel puede esconder un coste de coordinación enorme. Además, puede ocurrir que nadie dentro de la organización tenga ya una visión completa de lo que está pasando.
El error contrario a pensar que «un modelo puede hacerlo todo» es creer que «muchos agentes pueden hacerlo todo juntos». Una red de agentes no es automáticamente más competente, igual que una reunión con diez personas no tiene por qué ser más eficaz que el trabajo de una sola persona bien preparada.
Seguridad: delegar también significa repartir poder
La orquestación no tiene que ver únicamente con ahorrar dinero. Cuando un agente dispone de herramientas para trabajar, puede buscar documentos, ejecutar código, modificar un repositorio, enviar comunicaciones, actualizar una base de datos o poner en marcha procesos de una empresa.
En ese momento, la pregunta ya no es solo «¿el texto que ha generado está bien?», sino también «¿qué acciones puede realizar realmente este sistema en el mundo real?».
Hay algunos principios que siguen siendo importantes independientemente de la arquitectura que utilicemos:
- Mínimo privilegio: cada agente debe tener únicamente los permisos necesarios para realizar su tarea.
- Separación de permisos: hay que diferenciar claramente entre consultar información, modificarla y realizar acciones irreversibles.
- Confirmación humana: los envíos, las compras, las eliminaciones, las publicaciones y los cambios en producción deberían requerir aprobación de una persona.
- Registro y trazabilidad: debemos poder reconstruir qué plan se siguió, qué herramientas se utilizaron, qué fuentes se consultaron, qué resultado se generó, quién lo revisó y si fue necesario escalar el caso.
- Aislamiento: los agentes que ejecutan código o trabajan con información que no podemos considerar de confianza deben hacerlo en entornos controlados.
- Protección frente a instrucciones maliciosas: hay que evitar que instrucciones ocultas en documentos, páginas web o entradas externas puedan manipular el comportamiento del sistema.
Dicho de forma sencilla, un orquestador también es un sistema de permisos y autorizaciones. Decidir quién hace cada tarea significa decidir quién puede actuar sobre qué recursos y con qué límites.
Las métricas que realmente importan
Antes de afirmar que un flujo de trabajo es mejor que el anterior, deberíamos medir cuidadosamente al menos algunas variables.
- Tasa de éxito en tareas reales: porque un sistema económico que no consigue resolver los problemas no es eficiente, por mucho que cueste poco.
- Calidad frente a una referencia: necesitamos compararlo con una alternativa concreta, ya sea un único modelo o un proceso realizado íntegramente por personas.
- Coste total del proceso: hay que incluir el router, los agentes que ejecutan las tareas, los revisores, los nuevos intentos, las herramientas externas y la supervisión humana que sigue siendo necesaria. No basta con medir el precio del modelo más avanzado.
- Tiempo total de respuesta: añadir más fases puede convertir una respuesta rápida en una espera demasiado larga.
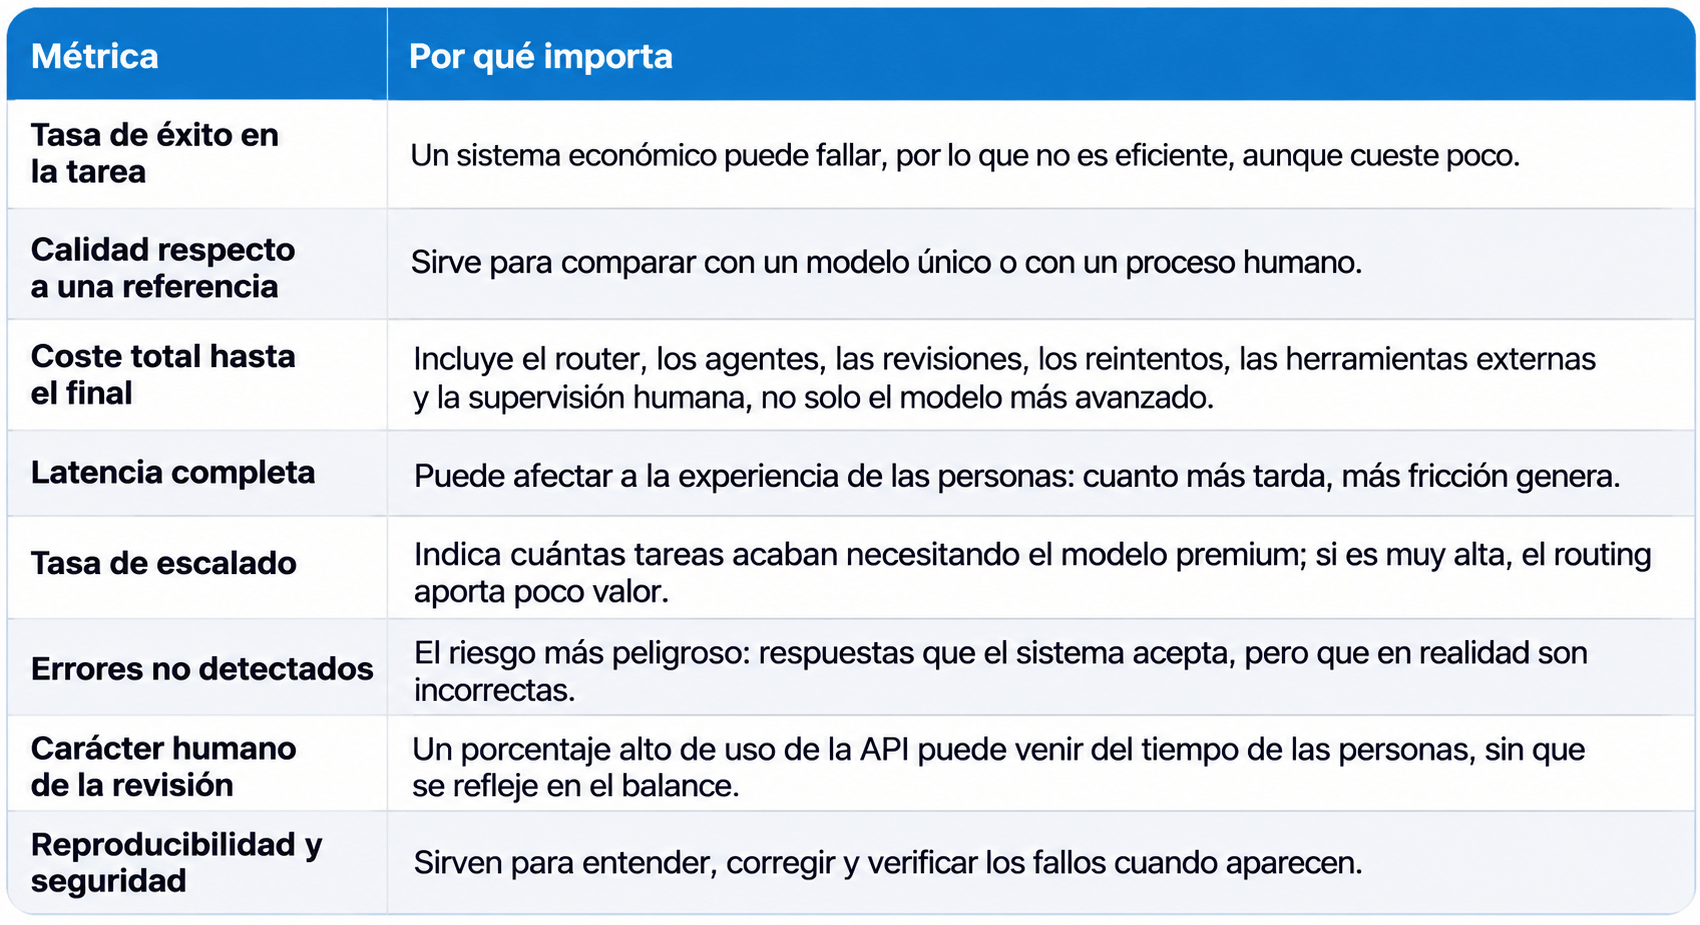
La tasa de escalado también nos da mucha información: si casi todas las tareas acaban pasando igualmente al modelo premium, el routing sirve de poco. Los errores que el sistema no detecta siguen siendo el mayor riesgo: respuestas que el sistema acepta, pero que en realidad son incorrectas.
También hay que tener en cuenta el tiempo que las personas dedican a revisar los resultados. El ahorro en los costes de las API puede acabar trasladándose al tiempo de trabajo de los equipos, sin que ese coste adicional aparezca reflejado en ninguna parte del presupuesto.
Por último, la reproducibilidad y la seguridad completan el análisis. Son fundamentales para poder entender, corregir y comprobar los fallos cuando, inevitablemente, aparecen.
Aquí volvemos directamente al caso de Astra Flash Orchestrator. El ahorro de tokens de Astra es un dato interesante, pero por sí solo no demuestra que este flujo de trabajo sea mejor. Lo que realmente importa es la eficiencia global, manteniendo el mismo nivel de calidad y riesgo.
Conclusión: de la IA como modelo a la IA como organización
La pregunta «¿cuál es el mejor modelo?» no va a desaparecer. Sigue siendo importante para entender qué capacidades tenemos disponibles en cada momento. Pero, por sí sola, cada vez explica menos cómo funcionan realmente las aplicaciones de inteligencia artificial que utilizamos en nuestro día a día.
Un sistema moderno puede utilizar un modelo para planificar, otro para realizar tareas repetitivas, una herramienta externa para comprobar datos o ejecutar acciones concretas y, por último, recurrir a una persona para aprobar aquello que nunca debería automatizarse por completo.
Los artículos sobre task switching, el caso de Fable 5 y Opus 5 y herramientas como Astra Flash Orchestrator cuentan, desde diferentes perspectivas, una misma transformación: estamos dejando de entender la inteligencia artificial como un único interlocutor al que podemos pedirle cualquier cosa. Cada vez se parece más a una infraestructura formada por sistemas de delegación, mecanismos de control, herramientas y responsabilidades compartidas.
La conclusión que debemos tener presente es que no podemos confundir lo que promete una tecnología con los resultados que realmente consigue.
La verdadera innovación no consiste simplemente en hacer que muchos modelos colaboren entre sí, aunque tengan nombres llamativos y anuncien porcentajes de ahorro impresionantes. Consiste en diseñar un flujo de trabajo en el que cada paso tenga sentido, se pueda medir, comprobar y, sobre todo, esté supervisado por alguien que asuma la responsabilidad de lo que ocurre.