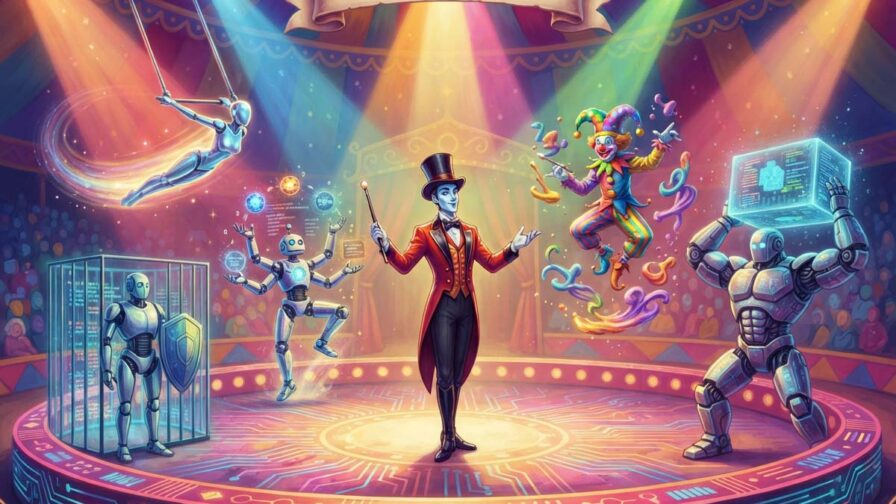
Per molto tempo la corsa all’intelligenza artificiale è sembrata una gara lineare, ogni laboratorio impegnato a costruire il modello più grande, più costoso e più capace disponibile sul mercato. Ma nelle applicazioni reali quel modello “migliore” rischia di essere sprecato su operazioni che non richiedono affatto la sua potenza, riassumere una nota, estrarre una data da un documento, produrre una prima bozza, applicare una modifica ripetitiva a un file di codice. Il cambiamento che si sta consolidando in questi mesi non consiste quindi soltanto nell’addestrare modelli linguistici più performanti. Consiste nel costruire sistemi capaci di decidere, momento per momento, quale modello, agente o strumento debba intervenire, e quando invece sia necessario fermarsi, verificare o chiedere a una persona.
Andrew Ng, tra i divulgatori più ascoltati del settore, ha da tempo indicato reflection, uso di strumenti, pianificazione e collaborazione multi-agente come quattro pattern fondamentali dei cosiddetti workflow agentici, e il punto comune a tutti e quattro è che il modello non è più costretto a produrre una risposta definitiva in un solo passaggio.
Da dove riparte il discorso
Questo articolo prosegue un filone già aperto su Codemotion. Nel primo pezzo, dedicato al task switching, avevo raccontato come per la maggior parte delle attività quotidiane non serva affatto il modello più recente, e come una gerarchia consapevole di strumenti, dal flagship al modello locale gratuito, permetta di scegliere lo strumento giusto per il compito giusto invece di inseguire sempre l’ultima uscita. Recentemente sul mio portale, ho parlato secondo, del sorpasso di Opus 5 su Fable 5, quella intuizione teorica ha trovato conferma nei numeri: le aziende, di fronte a un modello di punta più caro e vincolato, hanno iniziato a spostare la spesa su alternative più economiche riservando il top di gamma solo ai compiti che lo giustificano davvero.
Il passo successivo, naturale, è chiedersi cosa succeda quando non si cambia modello una sola volta all’inizio della conversazione, ma si costruisce un sistema che distribuisce il lavoro lungo l’intero processo, con ruoli diversi assegnati in automatico e non da un utente che sceglie manualmente da un menù a tendina.
Cosa significa davvero switching
Nella sua forma più semplice lo switching è model selection, cioè la scelta del modello più adatto prima ancora di elaborare la richiesta. In una forma più sofisticata diventa routing, l’uso di segnali sul prompt, sul dominio, sul rischio o sul costo previsto per inviare il compito lungo un percorso piuttosto che un altro. In una forma ancora più dinamica si trasforma in cascade, il tentativo di risolvere il problema con un modello economico e la scalata verso uno più forte soltanto se l’output non viene ritenuto sufficiente. Negli agenti, infine, lo switching diventa delegation, il task viene suddiviso e assegnato a ruoli distinti, spesso dotati di modelli, strumenti e permessi differenti tra loro.
Un esempio concreto aiuta a fissare l’idea. Una richiesta di assistenza clienti sullo stato di una spedizione può essere risolta in pochi secondi da un modello economico, mentre un reclamo che coinvolge un rimborso di importo elevato o un possibile problema normativo richiede un modello più capace, l’accesso a documenti aggiuntivi e, spesso, una revisione umana prima di chiudere il caso.
Dal modello unico al sistema composto
La svolta si può raccontare con una metafora semplice. Il modello monolitico è un professionista eccezionale a cui viene chiesto di occuparsi di tutto, dal lavoro amministrativo più noioso alla diagnosi più complessa. Il sistema orchestrato somiglia invece a una redazione o a un team di sviluppo, dove i compiti vengono assegnati in base a competenza, costo, strumenti disponibili e livello di responsabilità richiesto.
Il punto da tenere fermo è che non si tratta necessariamente di un’intelligenza artificiale “più intelligente” nel senso stretto del singolo modello linguistico. Può trattarsi, più semplicemente, di un sistema più efficace perché impiega meglio il calcolo che ha a disposizione. Un modello piccolo o rapido può occuparsi di selezione, estrazione, classificazione e prima stesura; un modello di frontiera può essere richiamato solo per pianificazione, casi ambigui, decisioni ad alto impatto o controllo finale; uno strumento esterno, non un modello linguistico ma un vero pezzo di software, può verificare dati, eseguire test o interrogare un database con una precisione che nessun LLM garantisce nativamente.
Routing, cascata e delega: la mappa delle tecniche
Il router è, in un certo senso, il centralinista del sistema. Riceve una richiesta e ne stima natura e difficoltà, domanda breve o lunga, conoscenza generale o ragionamento strutturato, contenuto a basso o alto rischio, necessità o meno di strumenti esterni. Può farlo con regole esplicite scritte da chi progetta il sistema, con un classificatore dedicato, con un altro modello linguistico usato come arbitro, oppure con un sistema appreso sui dati che stima il rapporto atteso fra qualità e costo per ciascun modello disponibile.
Il router, però, è già una decisione fallibile. Se sottostima un compito, lo invia a un modello inadeguato e produce un risultato scadente; se sovrastima tutto per prudenza, annulla il vantaggio economico e finisce comunque per inviare ogni richiesta al modello più caro, vanificando il senso stesso dell’operazione.
Il cascade funziona diversamente. Nel routing puro il sistema decide prima di generare qualunque cosa, “questa domanda va al modello A”. Nella cascata il modello economico produce un primo output, e soltanto dopo il sistema stima se è sufficiente. In caso negativo l’output viene corretto, rigenerato, passato a un revisore o inoltrato a un modello più costoso. Il vero collo di bottiglia, qui, è proprio la stima di qualità: un sistema può basarsi su punteggi di confidenza, valutatori dedicati, test automatici, confronto tra più risposte o un secondo modello che fa da giudice, ma quel giudice può a sua volta sbagliare, condividere gli stessi pregiudizi del generatore o premiare risposte persuasive invece che corrette.
Un livello più ambizioso è la decomposizione del problema. Molti compiti reali non hanno una singola risposta, ma una catena di attività, interpretare l’obiettivo, trovare fonti, leggere documenti, confrontare opzioni, eseguire calcoli o codice, verificare vincoli, produrre un risultato e infine controllarlo. Un agente “planner” può generare un piano di sotto-task e assegnarne ciascuno in modo diverso, la ricerca a un agente con accesso a browser o database, l’elaborazione numerica a un ambiente Python, la scrittura ripetitiva a un modello veloce, il ragionamento più delicato a uno più potente, l’approvazione finale a una persona in carne e ossa.
Qui vale una precisazione importante: la decomposizione non è automaticamente un bene. Se il compito non è realmente scomponibile, frammentarlo distrugge contesto, introduce passaggi inutili e rende più difficile capire, a posteriori, chi abbia effettivamente sbagliato. Anthropic, che ha codificato diversi di questi pattern nella propria guida “Building effective agents”, definisce l’orchestrator-workers come un modello centrale che suddivide dinamicamente un compito, delega a modelli lavoratori e sintetizza il risultato finale, e lo considera particolarmente adatto ai problemi complessi in cui non è possibile sapere in anticipo quali sotto-task serviranno davvero, citando proprio il coding multi-file come esempio tipico.
L’ultimo livello è l’orchestrazione multi-agente vera e propria, quella che organizza non solo la scelta dei modelli ma l’intero processo, ruoli, ordine delle azioni, strumenti disponibili, memoria condivisa, controlli, permessi, gestione degli errori, condizioni di stop e responsabilità finale su chi risponde di un errore.
Il caso Astra Flash Orchestrator
Un caso concreto rende tutto questo meno astratto. Il repository astra-flash-orchestrator, pubblicato dallo sviluppatore Ethan+ (già autore di altri progetti agentici come l’assistente vocale Jarvis per Claude Code), è pensato come workflow nativo per Codex, l’ambiente di coding agentico di OpenAI. Il progetto lascia ad Astra il ruolo di pianificazione, architettura e revisione finale, mentre delega a DeepSeek V4.1 Flash, un modello nettamente più economico, l’implementazione vera e propria, il testing e il debugging di routine.
Il flusso, per come lo racconta l’autore in una discussione pubblica sul repository di Codex, è semplice da seguire. Di fronte a un obiettivo complesso, Astra interpreta la richiesta, ne delimita l’ambito e definisce i criteri di accettazione. DeepSeek Flash prende in carico l’implementazione, esplora il codice esistente, scrive le modifiche, esegue i test e ripara i problemi ordinari che emergono lungo il percorso. Astra, infine, valuta il diff prodotto, verifica l’aderenza al piano iniziale e accetta il lavoro oppure lo rimanda indietro per un’altra iterazione. Il primo passaggio è quindi planning e task decomposition, il secondo è delega vera e propria a un lavoratore più economico, i test automatici forniscono un feedback esterno più affidabile della semplice autovalutazione linguistica, il ritorno eventuale al lavoratore è un ciclo di correzione, non una risposta prodotta in un solo colpo.
Il punto interessante non è il nome dei modelli coinvolti, che a breve saranno probabilmente sostituiti da altri. È che l’esempio mostra in modo molto leggibile come un sistema possa riservare il modello più costoso a ciò che richiede giudizio e responsabilità, lasciando il lavoro di volume, ripetitivo per definizione, a un lavoratore molto più economico. Astra resta supervisore, Flash produce gran parte dell’output operativo: è una distribuzione asimmetrica di potere decisionale, non semplicemente un modello economico al posto di uno caro.
La promessa economica e ciò che non dimostra
Qui vale la pena assumere un tono più scettico. Nella discussione originale su GitHub, l’autore racconta di aver ridotto l’uso di Astra di circa il 94 per cento su una sessione di sviluppo di ventitré ore. Una copertura successiva del progetto, pubblicata da RuntimeWire, riporta invece una riduzione fino al 98,9 per cento dell’input consumato da Astra ogni mille righe di implementazione e test, misurata però su un singolo confronto locale, non su un benchmark controllato. Sono due numeri diversi, misurati in modi diversi, e vanno letti come tali: dichiarazioni dell’autore del progetto, non una valutazione indipendente e generalizzabile a qualunque tipo di lavoro.
Cosa dovrebbe indicare, invece, un benchmark davvero informativo? Modelli esatti, versioni, prezzi e data della misurazione. Tipo, dimensione e difficoltà dei repository testati. Numero di task affrontati, tasso di successo e definizione operativa di “stessa qualità”. Token generati da tutti gli agenti coinvolti, non solo dal modello premium messo sotto la lente. Costo degli errori, cioè retry, correzioni, contesto aggiunto e tempo umano speso a sistemare ciò che non ha funzionato. Latenza end to end, non solo i token risparmiati sulla carta. Tasso di regressioni e gravità degli errori non intercettati. Condizioni precise in cui il workflow delegato peggiora rispetto al modello di punta usato direttamente, senza intermediari.
Va aggiunto un dettaglio non secondario: al momento della pubblicazione di questo articolo il repository non ha ancora release pubblicate, segno di un progetto ancora giovane e sperimentale più che di uno strumento maturo pronto per la produzione. Risparmiare token del modello premium, va detto con chiarezza, non equivale automaticamente a risparmiare denaro, tempo o rischio complessivo.
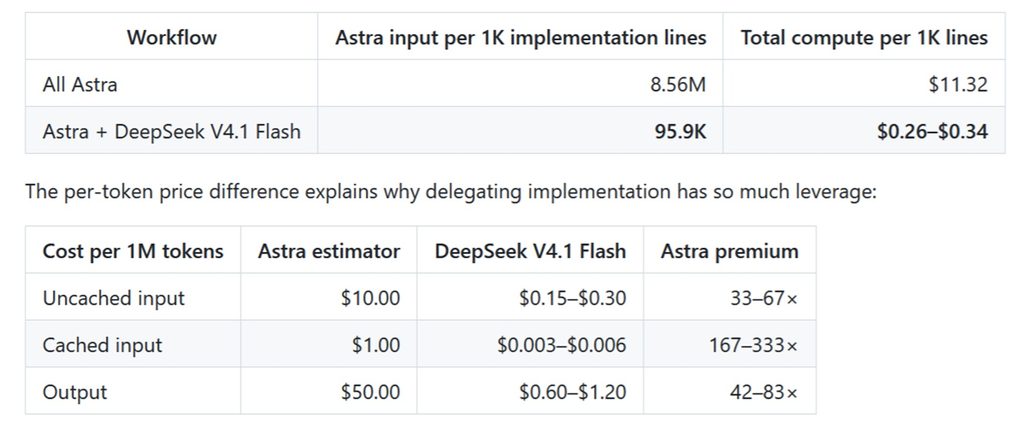
Screenshot dal repository ufficiale su GitHub
Verificare è difficile quanto delegare
C’è un videogioco indipendente, Return of the Obra Dinn, in cui il giocatore deve ricostruire la sorte di un intero equipaggio partendo da frammenti di prove ambigue, un fermo immagine, una frase colta a metà, un dettaglio nella disposizione dei corpi, e il gioco conferma la correttezza di una deduzione solo dopo che almeno tre fatti collegati sono stati indovinati insieme, non uno alla volta. È un paragone meno bizzarro di quanto sembri per il problema centrale dell’orchestrazione. Un sistema di delega funziona solo se possiede un segnale affidabile per capire quando l’output del lavoratore è effettivamente corretto, e quel segnale, quasi mai, arriva da un singolo controllo isolato: va costruito incrociando più indizi, proprio come nel gioco, altrimenti si finisce per accettare per buona una ricostruzione solo apparentemente coerente.
Nel coding alcuni segnali sono relativamente solidi, build riuscita, test unitari e di integrazione, analisi statica, linting, benchmark, diff revisionato da un umano o da un altro modello. Ma anche qui “tutti i test passano” non equivale automaticamente a “la modifica è corretta, sicura e coerente con l’intento originario del prodotto”: i test, dopotutto, li ha scritti qualcuno, e quel qualcuno può aver lasciato scoperti proprio i casi limite più insidiosi.
Nei compiti editoriali, di ricerca, legali o medici la verifica è molto più complessa. Un testo fluido può apparire perfettamente convincente pur contenendo fonti errate, citazioni inventate o inferenze non giustificate dal materiale di partenza. L’orchestrazione, va detto con onestà, non elimina il problema dell’affidabilità del sistema: lo sposta semplicemente dalla generazione alla progettazione dei controlli, che è un problema diverso, non necessariamente più facile da risolvere.
Non è un fenomeno isolato
Il caso Astra Flash si inserisce in una tendenza più ampia e più visibile nell’industria. Le piattaforme non si limitano ad aggiungere modelli sempre più grandi, ma stanno costruendo strumenti per comporre agenti, farli dialogare tra loro, assegnare loro strumenti e farli cooperare attraverso workflow condivisi.
Un segnale concreto di questa direzione è l’emergere di protocolli di interoperabilità dedicati. Google ha presentato nell’aprile 2025 l’Agent2Agent Protocol, noto come A2A, pensato per consentire ad agenti costruiti su framework o piattaforme differenti di comunicare, scambiare informazioni e coordinare azioni tra loro. Due mesi dopo, a giugno, Google ha donato il protocollo alla Linux Foundation, affiancata in questo passaggio da aziende come AWS, Cisco, Salesforce, SAP e ServiceNow. Il dettaglio della donazione conta più di quanto sembri: mostra che la discussione si sta spostando dall’agente isolato, costruito da un singolo fornitore, alla compatibilità fra interi sistemi di agenti prodotti da fornitori diversi. Non va presentato come prova che il problema della delega sia risolto, è piuttosto un indicatore che interoperabilità e coordinamento sono ormai considerati problemi infrastrutturali seri, non più esperimenti da conferenza.
Le opinioni che contano
Anthropic sostiene un approccio pragmatico nella sua guida sulla costruzione di agenti: partire dalla soluzione più semplice possibile e introdurre agenti, routing e autonomia aggiuntiva soltanto quando il guadagno misurato giustifica la complessità in più. Nel suo schema, l’orchestrator-workers è utile proprio quando i sotto-task non sono prevedibili in anticipo, come accade spesso nel coding che tocca più file contemporaneamente.
Andrew Ng, dal canto suo, identifica reflection, tool use, planning e collaborazione multi-agente come pattern centrali di quello che chiama design agentico. La sua prospettiva conta perché rimette la progettazione del workflow al centro della discussione: spesso il miglioramento reale non deriva soltanto dall’ultimo modello disponibile sul mercato, ma dalla sequenza con cui il sistema pianifica, agisce, riceve un feedback esterno e si corregge di conseguenza.
OpenAI, nella propria guida operativa sull’ottimizzazione degli agenti, consiglia di misurare sempre una baseline prima di intervenire, poi procedere per gradi: igiene del contesto passato al modello, controllo degli strumenti disponibili, instradamento dei passaggi più semplici verso modelli più piccoli, caching dei prompt ripetuti, separazione tra lavoro in tempo reale e lavoro asincrono, monitoraggio continuo e valutazioni sistematiche. La guida avverte implicitamente anche contro il routing indiscriminato: troppa logica di smistamento può aggiungere solo overhead quando il compito, in realtà, era già semplice in partenza.
La sintesi possibile è questa: non esiste, tra le fonti più operative, una scuola seria secondo cui moltiplicare gli agenti sia sempre e comunque un bene. Convergono piuttosto su un principio più sobrio, introdurre complessità solo quando misurazioni ripetute dimostrano che quella complessità migliora davvero il risultato.
Dove questa architettura ha senso, e dove no
La convenienza dell’orchestrazione dipende da quanto un compito è ripetibile, misurabile e dotato di controlli chiari. Nel supporto clienti, classificazione delle richieste, recupero di risposte da una base di conoscenza e bozze di prima risposta si delegano bene, mentre reclami complessi, eccezioni e rimborsi di importo elevato restano territorio per l’escalation. Nello sviluppo software, ricerca nel repository, modifiche ripetitive, test e linting sono terreno adatto alla delega, mentre decisioni di architettura, migrazioni importanti e revisioni di sicurezza restano appannaggio del modello più capace o, meglio ancora, di una persona.
Nella ricerca editoriale, quella che questo stesso articolo ha praticato, come ogni volta che ne scrivo uno, l’estrazione da documenti, il clustering di fonti simili e una prima sintesi possono essere delegati a un lavoratore più economico, ma la selezione delle fonti affidabili, il controllo delle citazioni e la formulazione di un giudizio devono rimanere sotto revisione umana diretta, perché è lì che si gioca la credibilità del pezzo finito.
Il costo nascosto del coordinamento
Ogni agente o passaggio aggiunto a un workflow comporta più chiamate, più token consumati e potenzialmente più latenza complessiva. Comporta più contesto da trasferire o riassumere tra un nodo e l’altro del sistema, più possibilità che un errore iniziale si propaghi lungo la catena senza essere intercettato, più difficoltà nel riprodurre e diagnosticare un fallimento dopo che si è verificato. Comporta anche più credenziali, strumenti, permessi e superfici di attacco da gestire, e più complessità nel ricostruire, a posteriori, quale modello o agente abbia effettivamente preso una certa decisione.
L’efficienza apparente nasconde un costo di coordinamento enorme, e nessuno nell’organizzazione ha più una visione d’insieme di cosa stia realmente accadendo. L’errore opposto a “un modello fa tutto” è “molti agenti fanno tutto insieme”: una rete di agenti non è automaticamente più competente, così come una riunione con dieci partecipanti non è automaticamente più efficace di una persona preparata che lavora da sola.
Sicurezza: delegare significa anche distribuire potere
L’orchestrazione non riguarda soltanto l’efficienza economica. Quando un agente possiede strumenti operativi, può cercare documenti, eseguire codice, modificare un repository, inviare comunicazioni, aggiornare un database o avviare un processo aziendale. A quel punto la domanda non è più solo “il testo prodotto è buono?”, ma “quali azioni può realmente compiere questo sistema nel mondo reale?”.
Alcuni principi restano validi indipendentemente dall’architettura scelta: il minimo privilegio, per cui ogni lavoratore ha solo i permessi strettamente necessari al suo compito, la separazione netta tra lettura, scrittura e azioni irreversibili, la richiesta di conferma umana per invii, acquisti, cancellazioni, pubblicazioni e modifiche in produzione. Servono log e tracciabilità completi, così che piano, strumenti chiamati, fonti consultate, output prodotto, revisore ed eventuale escalation possano sempre essere ricostruiti a posteriori. Serve isolamento per i lavoratori che eseguono codice o manipolano materiale non fidato, e una difesa attiva contro l’iniezione di istruzioni nascoste in documenti, pagine web o input esterni. Un orchestratore, detto senza troppi giri di parole, è anche un sistema di autorizzazione: decidere chi esegue cosa significa decidere chi può agire su quali risorse, e con quali limiti precisi.
Le metriche che contano davvero
Prima di dichiarare un workflow “migliore” del precedente andrebbero misurate almeno alcune variabili con attenzione. Il tasso di successo sul compito reale, perché un sistema economico ma fallimentare non è affatto efficiente, per quanto costi poco. La qualità rispetto a una baseline concreta, un modello singolo o un processo interamente umano con cui confrontarsi onestamente. Il costo totale end to end, che include router, lavoratori, revisori, retry, strumenti esterni e supervisione umana residua, non solo il prezzo del modello di punta. La latenza complessiva, perché più fasi aggiunte possono trasformare una risposta rapida in un’attesa fastidiosamente lunga.
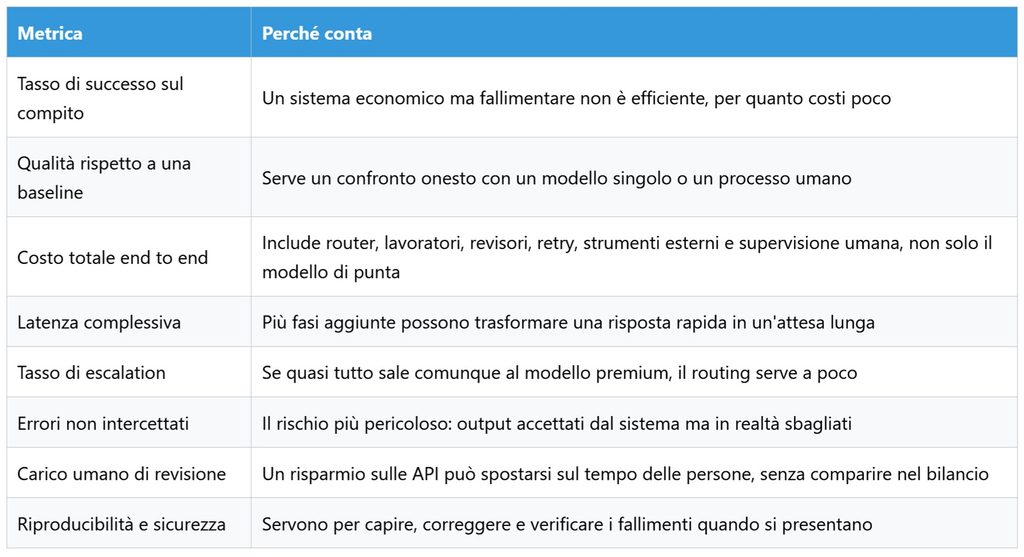
Il tasso di escalation dice molto: se quasi tutto finisce comunque per salire al modello premium, il routing serve a poco. Gli errori non intercettati restano il rischio più pericoloso in assoluto, output accettati dal sistema ma in realtà sbagliati. Il carico umano di revisione conta altrettanto, perché un risparmio sui costi delle API può facilmente spostarsi sul tempo delle persone, senza che questo risulti da nessuna parte nel bilancio. Riproducibilità e sicurezza chiudono il quadro, servono per capire, correggere e verificare i fallimenti quando, inevitabilmente, si presentano. Qui il richiamo ad Astra Flash Orchestrator è diretto: il claim sui token risparmiati da Astra è un dato utile, ma da solo non basta a stabilire la superiorità di un workflow. La misura che conta davvero resta sempre l’efficienza complessiva, a parità di qualità e di rischio.
Conclusione: dall’AI come modello all’AI come organizzazione
La domanda “qual è il modello migliore” non scompare, resta decisiva per capire le capacità di base disponibili in un dato momento. Ma da sola descrive sempre meno il funzionamento reale delle applicazioni di intelligenza artificiale che le persone usano ogni giorno. Un sistema moderno può scegliere un modello per pianificare, un altro per svolgere il lavoro ripetitivo, uno strumento esterno per verificare dati o eseguire azioni concrete, e una persona per approvare ciò che non deve mai essere automatizzato del tutto.
Gli articoli sul task switching, il caso di Fable 5 e Opus 5, e strumenti come Astra Flash Orchestrator raccontano quindi la stessa trasformazione da angolazioni diverse: l’intelligenza artificiale sta smettendo di essere pensata come un singolo interlocutore a cui rivolgersi per tutto. Sta diventando, sempre più chiaramente, un’infrastruttura fatta di delega, controllo, strumenti e responsabilità distribuita.
La conclusione critica da tenere ferma è che la promessa non va mai confusa con il risultato ottenuto. La vera innovazione non consiste semplicemente nel far collaborare molti modelli tra loro, magari con nomi in codice suggestivi e percentuali di risparmio impressionanti da titolo. Consiste nel progettare un workflow in cui ogni singolo passaggio sia utile, misurabile, verificabile e, soprattutto, governato da qualcuno che se ne assume la responsabilità.