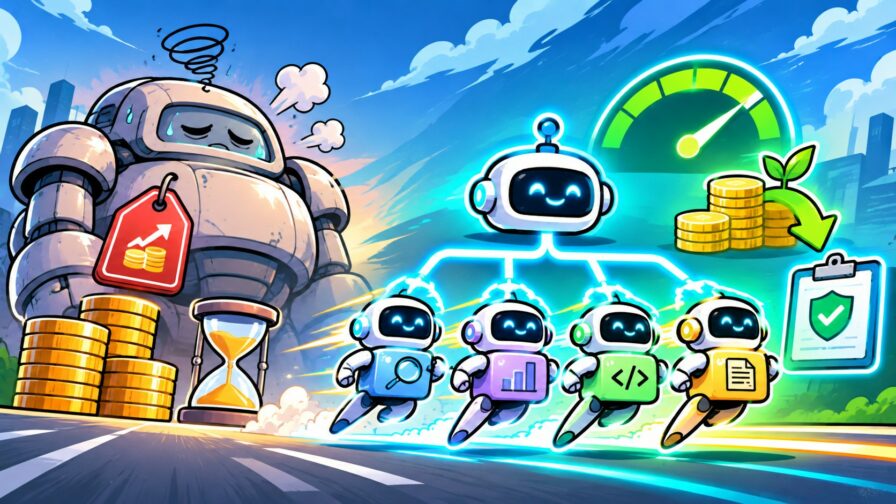
Cada vez que un desarrollador le pide a un modelo propietario de 400.000 millones de parámetros que resuelva un 2 + 2 o dé formato a un JSON, en algún lugar del mundo una GPU H100 llora y a alguien de Finanzas le llega una notificación de que se ha pasado del presupuesto.
En el meetup mensual organizado por ENG (Engineering), y gracias a Andrea Raponi, Daniele Scasciafratte y Eugenio Petullà, se desmontó pieza a pieza el discurso de «un único modelo para gobernarlos a todos».

La idea principal está clara: si queremos desarrollar productos basados en IA que puedan crecer sin disparar el gasto en computación ni chocarse con los requisitos normativos europeos, tenemos que dejar de tratar la IA como una caja negra y empezar a hacer lo que mejor sabemos hacer: ingeniería de software y de sistemas.
La paradoja de la inferencia: tokens, VRAM y el apetito del KV Cache
Cuando llamamos a un LLM, el tokenizer divide el texto en unidades mínimas llamadas tokens. Después, estas unidades se convierten en embeddings vectoriales y se procesan en la GPU. Y es aquí donde aparece el primer cuello de botella: el KV Cache (Key-Value Cache).
Para no tener que recalcular la atención sobre todos los tokens anteriores cada vez que se genera una nueva palabra, el motor de inferencia guarda los tensores key y value en la memoria de vídeo de la tarjeta gráfica (VRAM).
Cuanto más crece el contexto —hasta llegar al millón de tokens que promete el mercado—, más memoria ocupa esta caché. Y eso reduce la capacidad de procesar varias solicitudes al mismo tiempo.
- Si el KV Cache tiene que permanecer íntegramente en la memoria de vídeo ultrarrápida, la capacidad de atender peticiones simultáneas se desploma en cuanto aumenta el número de usuarios.
- Si intentamos mover la caché al disco o a otro almacenamiento para reducir costes, la latencia por token generado puede pasar de unas pocas decenas de milisegundos a varios segundos.
Solicitud del desarrollador (HTTPS)
   ──> Tokenizer (divide el texto en tokens)
   ──> Generación de embeddings vectoriales
   ──> Núcleo de la GPU (procesamiento de atención)
   ──> KV Cache (la VRAM se va ocupando para mantener el contexto)
vLLM vs. SGLang: dos formas de entender la inferencia
La capa que se encarga de gestionar todo este proceso es el motor de inferencia. Actualmente, dos plataformas destacan en este terreno:
- vLLM: el veterano del sector. Está escrito principalmente en Python y cuenta con el respaldo de fabricantes de hardware como Nvidia y AMD. Introdujo PagedAttention, una arquitectura que gestiona la memoria de vídeo de forma similar a la memoria virtual paginada de los sistemas operativos. Es una solución robusta, aunque su ritmo de evolución y lanzamiento de versiones está condicionado por una base de código bastante monolítica.
- SGLang: un motor más moderno basado en RadixAttention. En lugar de gestionar la caché como un conjunto de páginas independientes, organiza la memoria compartida en forma de árbol o grafo. En arquitecturas con varias interacciones o flujos de agentes que utilizan los mismos system prompts, puede reutilizar gran parte de los cálculos que ya se han realizado.
Cumplimiento normativo y Zero Data Retention: la AI Act no hace descuentos
Una aplicación empresarial no falla únicamente porque tenga demasiada latencia. También puede quedarse bloqueada cuando el departamento Legal no da luz verde al despliegue.
Entre el RGPD y la aplicación progresiva de la Ley de IA europea (EU AI Act), confiar en servicios externos cuyos términos de uso se reservan el derecho a conservar registros para entrenar o ajustar modelos puede exponer a las empresas a sanciones y poner en riesgo sus secretos comerciales.
La AI Act distingue claramente entre quienes entrenan modelos fundacionales desde cero y quienes simplemente ofrecen servicios de inferencia utilizando modelos de pesos abiertos que ya han sido validados.
Para garantizar el cumplimiento normativo, la infraestructura de inferencia debe respetar varios principios fundamentales:
- Soberanía del dato: los servidores y centros de datos deben estar ubicados en territorio nacional o europeo. Un ejemplo son los nodos italianos de Regolo/Seeweb, situados entre Frosinone y Lombardía.
- Zero Data Retention (ZDR): los prompts y las respuestas generadas no deben almacenarse en los discos de la infraestructura. La única información que se conserva es la relativa al consumo —tokens utilizados, modelo invocado y tiempo de ejecución—, necesaria para la facturación.
- Caché de prompts cifrada: si se activa una caché persistente de prefijos para mejorar el rendimiento, debe cifrarse con claves únicas para cada cliente (tenant) y así evitar comprometer la política ZDR.
- Impacto ESG y energía verde: la inferencia también tiene un coste medioambiental. Utilizar infraestructuras alimentadas al 100 % por energías renovables y disponer de métricas visibles sobre gramos de CO₂ y milivatios consumidos por prompt permite incorporar datos concretos a los informes de sostenibilidad.
De la catedral a la obra: arquitectura basada en subagentes
Enviar una tarea completa de revisión de código o análisis de arquitectura a un modelo generalista gigantesco genera facturas difíciles de justificar y respuestas que, muchas veces, se quedan en la superficie.
Una estrategia de ingeniería más eficiente consiste en repartir el trabajo entre modelos especializados que colaboran de forma asíncrona:
                     ┌──> [Subagente 1: Mistral] ──> Análisis crítico y detección de errores
[Orquestador: GLM] ──┼──> [Subagente 2: Gemma]   ──> UI/UX y código frontend
                     └──> [Subagente 3: Qwen]    ──> Ejecución de tareas específicas y lógica principal
- GLM (por ejemplo, GLM-5) como orquestador: los modelos de mayor tamaño pueden gestionar contextos amplios sin perder el foco. Se encargan de planificar las tareas, consultar a los subagentes y combinar los resultados.
- Mistral (Large) como revisor crítico: un modelo europeo con buenas capacidades de análisis y comprensión multilingüe, especialmente útil para detectar fallos lógicos, casos límite y problemas de arquitectura.
- Qwen (familia de modelos) como ejecutor de tareas: los modelos chinos ofrecen una buena relación entre coste y número de tokens para tareas de programación concretas. Si les damos una tarea bien delimitada —por ejemplo, «haz esta refactorización»—, pueden ejecutarla con precisión. Eso sí, no son la mejor opción para actuar como orquestadores abiertos, ya que pueden generar alucinaciones estructurales.
- Gemma (31B) como especialista en frontend y UI/UX: un modelo ágil y eficaz para diseñar componentes, pulir interfaces —por ejemplo, con Qt o HTML— y comprender la lógica visual.
Context Engineering: el caso de Linus Torvalds y smallchat, el proyecto de Antirez
Un modelo de IA publicado hace un año no conoce los últimos parches, las nuevas versiones de los frameworks ni las prácticas internas de tu repositorio. ¿Cómo podemos evitar el coste desorbitado de entrenarlo continuamente con nuevo hardware?
La respuesta está en las Skills modulares: archivos Markdown especializados que se incorporan al contexto del modelo para darle instrucciones y conocimientos concretos.
Daniele Scasciafratte compartió un experimento que muestra cómo funciona este enfoque en la práctica:
- Se creó un proceso para analizar 38.000 correos electrónicos escritos por Linus Torvalds durante veinte años en la lista de correo del kernel de Linux.
- A partir de ese contenido, se extrajeron y sintetizaron sus criterios y métodos para revisar código, creando una Skill reutilizable en formato Markdown.
- Después, se aplicó esa Skill a la revisión de código de smallchat, un proyecto en C++ de Salvatore Sanfilippo (Antirez), compuesto por unos diez archivos.
Los resultados de la prueba hablan por sí solos:
- Sin la Skill: los modelos analizan el código con criterios generales y detectan principalmente problemas superficiales.
- Con la Skill incorporada al contexto: modelos como Mistral identificaron vulnerabilidades muy concretas relacionadas con la gestión de memoria y las condiciones de carrera (race conditions). La profundidad del análisis llegó a superar la de modelos más grandes que no disponían de ese contexto específico.
- La paradoja del modelo monolítico: modelos enormes como GLM detectaron menos anomalías cuando se les proporcionó esta Skill que otros modelos intermedios, como Mistral, con configuraciones más orientadas al análisis. Esto demuestra que el modelo más grande no siempre es el mejor para una tarea especializada.
ROI para desarrolladores: cómo ponerlo en práctica desde el lunes
Para aplicar esta estrategia sin tener que reescribir toda la base de código de una aplicación, el primer paso es desacoplar los componentes.
- Adopta la compatibilidad con OpenAI: evita los SDK propietarios que te atan de pies y manos a un único proveedor. Utiliza endpoints compatibles con las API estándar —por ejemplo, proveedores europeos de inferencia como
api.regolo.ai— y cambia únicamente la URL base y el token. - Implementa un router dinámico (por ejemplo, BRICK): no dejes que la elección del modelo para cada consulta dependa directamente del desarrollador. Utiliza routers semánticos de código abierto que clasifiquen automáticamente la complejidad de cada prompt. Así, las peticiones sencillas se envían a modelos de 9B parámetros y los modelos de más de 120B se reservan para tareas complejas.
- Organiza los prompts en Skills versionadas: guarda las instrucciones de funcionamiento en archivos Markdown controlados con Git. Así podrás actualizar los conocimientos y reducir errores de desarrollo sin tener que modificar ni una línea del código de los agentes.
Dejar de malgastar tokens no es solo una forma de cuidar el presupuesto de la empresa. Es también un requisito para construir software basado en IA que sea resistente, rápido y cumpla con la normativa antes de que llegue la siguiente notificación del proveedor cloud.