El OWASP Top 10 for Agentic Applications [1] define qué auditar en los agentes de IA. Durante 2026 el OWASP GenAI Security Project [2] ha publicado las piezas que faltaban para ejecutar esos controles: el Agent Control Standard, un LLM Top 10 basado en evidencia y un manual de red teaming. Este artículo propone cómo actualizar la práctica de seguridad agéntica.
Punto de partida: de auditar a ejecutar
La seguridad de la IA dejó de consistir en proteger un modelo estático para pasar a proteger agentes que razonan, usan herramientas y ejecutan acciones. El OWASP Top 10 for Agentic Applications 2026 [1] fijó el vocabulario de riesgo —ASI01 a ASI10: secuestro de objetivos, uso indebido de herramientas, abuso de identidad, cadena de suministro, ejecución de código, envenenamiento de memoria, comunicación entre agentes, fallos en cascada, explotación de la confianza y agentes maliciosos.
Este marco responde a qué auditar, pero deja abierta la pregunta operativa: cómo se imponen los controles en tiempo de ejecución. Una auditoría que detecta que un agente puede encadenar herramientas peligrosas no impide, por sí sola, que lo haga en producción. Durante 2026 el OWASP GenAI Security Project publica el LLM Top 10 2026, el Agent Control Standard y el GenAI Red Teaming Manual que dan continuidad al análisis previo sobre auditorías en aplicaciones agénticas publicado [3].
El LLM Top 10 2026 cambia el paradigma
La edición 2026 del OWASP Top 10 for LLM Applications [4] supone un cambio de filosofía donde el objetivo ya no es construir un modelo imposible de engañar, sino mejorar la seguridad de la aplicación que lo rodea para limitar el alcance de un ataque exitoso.
Para la seguridad agéntica, el cambio clave es el ascenso de Excessive Agency del puesto 6 al 3, impulsado por incidentes de agentes que ejecutan acciones de alto impacto. Además, System Prompt Leakage se renombra Hidden Context Exposure (LLM08) con un alcance ampliado, y Prompt Injection (LLM01) incorpora ataques multimodales ocultos en imagen o audio. OWASP remite de forma explícita los riesgos de agentes con herramientas, memoria entre sesiones y consecuencias downstream al Agentic Top 10. En la siguiente tabla vemos las diferencias entre las versiones de 2025 y 2026.
| 2026 | Riesgo | Cambio respecto a 2025 |
| LLM01 | Prompt Injection | Se mantiene en #1; ahora cubre ataques multimodales |
| LLM02 | Sensitive Information Disclosure | Se mantiene en #2 |
| LLM03 | Excessive Agency | Sube desde #6 (el mayor salto) |
| LLM04 | Supply Chain | Baja desde #3 |
| LLM05 | Data and Model Poisoning | Baja desde #4; añade subversión de fine-tuning |
| LLM06 | Unbounded Consumption | Sube desde #10 |
| LLM07 | Misinformation | Sube desde #9 |
| LLM08 | Hidden Context Exposure | Renombrado (antes System Prompt Leakage, #7), alcance ampliado |
| LLM09 | Vector and Embedding Weaknesses | Baja desde #8 |
| LLM10 | Improper Output Handling | Baja desde #5 |
Agent Control Standard (ACS): Zero Trust ejecutable
El Agent Control Standard [5] publicado en septiembre de 2026 es la pieza que convierte los principios Zero Trust en controles concretos. En lugar de clasificar riesgos, cataloga puntos de intercepción (hooks de middleware) que las plataformas de agentes exponen y sobre los que se aplican políticas de forma declarativa y portable entre frameworks. Cada hook devuelve un resultado de permitir, denegar o modificar, lo que permite verificar la identidad y el contexto en cada paso y ejecución que hace el agente. En este punto aplicaríamos técnicas de microsegmentación y validación por acción aplicadas en tiempo de ejecución.
| Hook | Momento del ciclo | Riesgos que ayuda a contener |
| Activación del agente | Inicio de la tarea | ASI01, ASI10 |
| Mensaje del usuario | Entrada | ASI01 (inyección), LLM01 |
| Respuesta del agente | Salida | ASI09, LLM10 |
| Petición de llamada a herramienta | Antes de invocar | ASI02, ASI03, ASI05 |
| Resultado de la herramienta | Tras invocar | ASI02, ASI04 |
| Recuperación de contexto de memoria | Lectura de memoria | ASI06 |
| Almacenamiento en memoria | Escritura de memoria | ASI06 |
| Recuperación de conocimiento | Consulta / RAG | ASI06, LLM08 |
Auditoría reproducible: red teaming en 8 fases
El GenAI Red Teaming Manual [6] publicado como primera versión en octubre de 2026 aporta a la auditoría una metodología formal y repetible, estructurada en ocho fases, que puede mapearse sobre los componentes agénticos que conviene revisar (razonamiento, orquestación de herramientas, identidad delegada, memoria y arquitectura multi-agente). Se complementa con el LLM Exploit Generation Guide 2.0 [7], que compara enfoques de explotación guiados por humanos y agentes autónomos.
En la práctica, el manual permite pasar de «probamos algunas inyecciones» a un ejercicio con alcance definido, objetivos de abuso, generación de casos, ejecución, análisis y criterios de salida. Aplicado a un agente, cada fase ataca un componente concreto:
- Inyección y desvío en la cadena de razonamiento (ASI01).
- Combinaciones peligrosas de herramientas y escape del sandbox (ASI02, ASI05).
- Escalada por autoridad delegada y tokens excesivos (ASI03).
- Envenenamiento de la memoria persistente (ASI06).
- Suplantación o alteración de mensajes entre agentes (ASI07).
Lo relevante no es la lista de ataques sino que ahora existe una estructura de ocho fases que los ordena y los hace reproducibles y auditables, con criterios de entrada y salida por fase. Para el detalle exacto de cada fase conviene remitir al manual, citado en las fuentes.
El eslabón que faltaba: seguridad de MCP
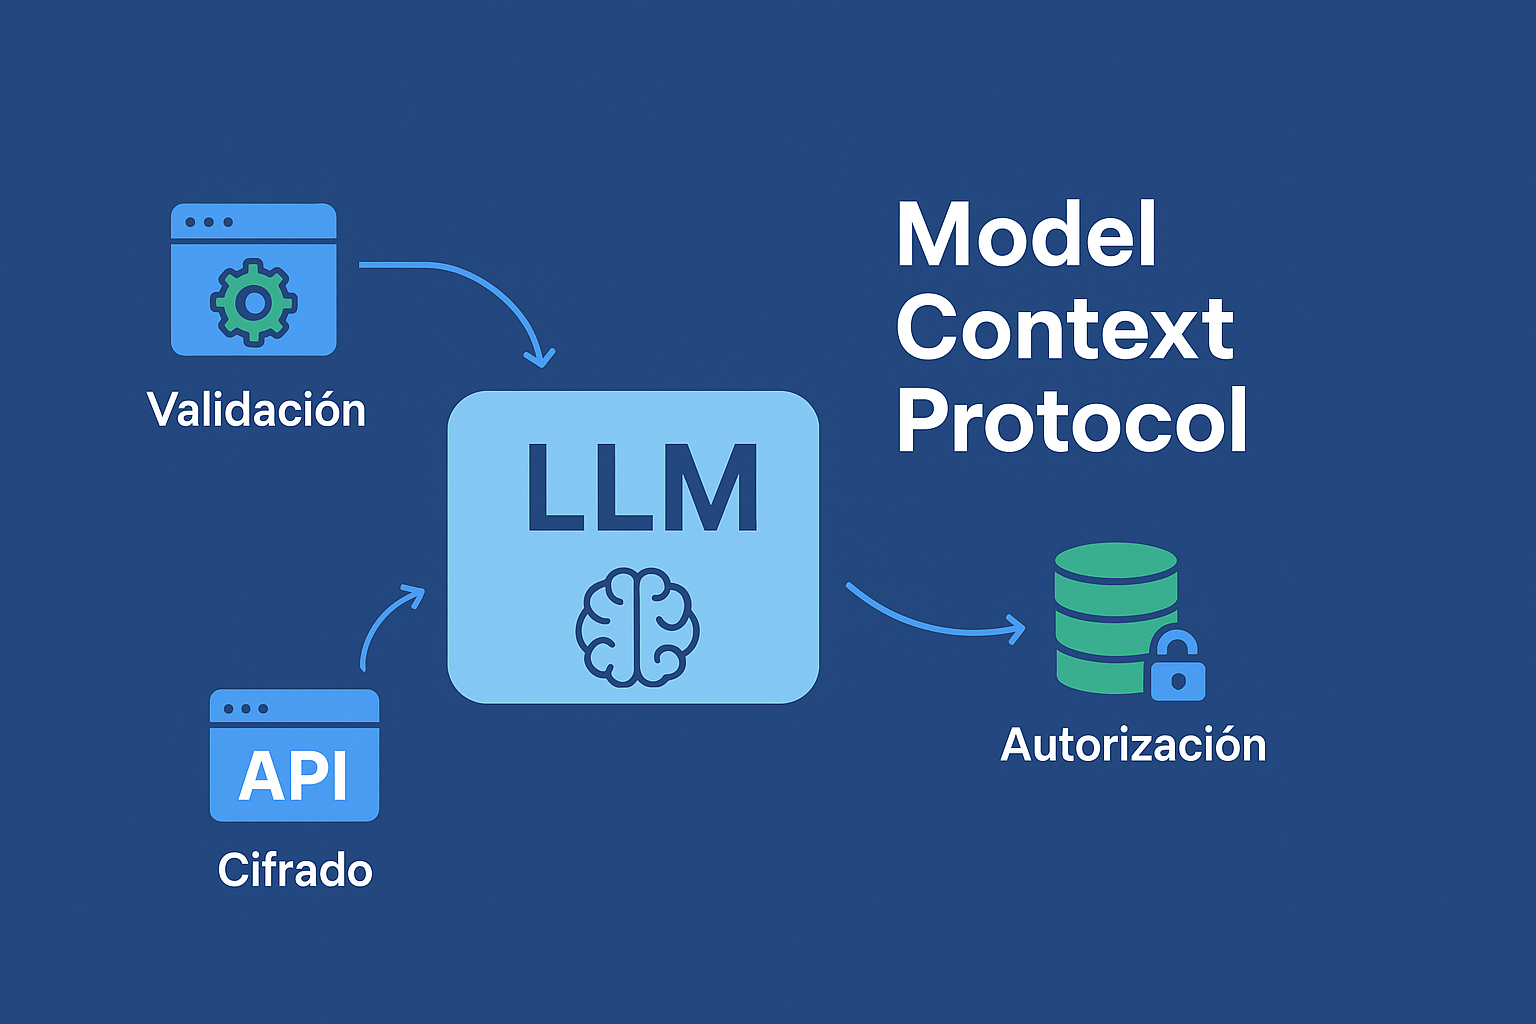
El Model Context Protocol (MCP) es hoy la vía habitual para conectar agentes con herramientas, APIs y fuentes de datos, y por tanto una superficie de ataque que afecta a la cadena de suministro (ASI04) y al uso indebido de herramientas (ASI02).
Las guías Practical Guide for Secure MCP Server Development [8] y CheatSheet: Using Third-Party MCP Servers [9] cubren la autenticación y autorización del servidor, la validación de entradas y salidas de cada herramienta, el mínimo privilegio en los tokens y la verificación de la procedencia de los servidores de terceros antes de conectarlos.
Gobernanza y cumplimiento
Para cerrar el círculo hacia la auditoría formal y el cumplimiento, dos recursos recientes ayudan. El GenAI Security Industry Framework Crosswalk [10] mapea 51 vulnerabilidades a marcos de seguridad y cumplimiento (NIST AI RMF, ISO/IEC 42001, EU AI Act), lo que permite justificar los controles ante auditores y reguladores. El OWASP AIBOM Generator [11] produce AI Bills of Materials para dar trazabilidad a la cadena de suministro de modelos, datos y componentes, en relación directa con ASI04. Como marco general, el informe State of Agentic AI Security and Governance ofrece el panorama de gobernanza en el que encajan estos controles.
Checklist práctico: de ASI a control y prueba
En la siguiente tabla, para cada riesgo del Agentic Top 10, se muestra un control que lo impone en ejecución (hook ACS o práctica) y una prueba de red teaming que lo verifica.
| Riesgo (ASI) | Control ejecutable | Prueba de red teaming |
| ASI01 Secuestro de objetivos | Hooks de mensaje y respuesta: deny/modify ante desvío | Inyección en la cadena de razonamiento |
| ASI02 Uso indebido de herramientas | Hook de petición de herramienta: deny de acciones incoherentes | Combinaciones peligrosas de herramientas |
| ASI03 Abuso de identidad | Tokens de corta duración + acceso JIT; hook de herramienta | Escalada por autoridad delegada |
| ASI05 Ejecución de código | Sandbox + hook de resultado de herramienta | Escape del sandbox |
| ASI06 Envenenamiento de memoria | Hooks de lectura/escritura de memoria y de RAG | Inyección en la memoria persistente |
| ASI07 Comunicación entre agentes | A2A autenticado y cifrado | Suplantación de mensajes entre agentes |
| ASI09 Explotación de la confianza | Validación humana para acciones de alto impacto | Dependencia ciega del usuario |
Referencias
[1] Securing Agentic Applications V2: https://genai.owasp.org/resource/securing-agentic-applications-v2
[2] OWASP GenAI Security Project — Resources: https://genai.owasp.org/resources/
[3] Seguridad y auditorías en aplicaciones agénticas de IA: https://www.codemotion.com/magazine/es/ciberseguridad/seguridad-y-auditorias-en-aplicaciones-agenticas-de-ia/
[4] OWASP LLM Top 10 2026: https://www.superblocks.com/blog/owasp-llm-top-10
[5] OWASP 2026 Agent Control Standard: https://agentpatterns.ai/security/owasp-2026-update-agent-control-standard/
[6] GenAI Red Teaming Manual https://genai.owasp.org/resource/genai-red-teaming-manual-version-1-0/
[7] LLM Exploit Generation Guide 2.0 https://genai.owasp.org/resource/llm-exploit-generation-guide-2-0/
[8] A Practical Guide for Secure MCP Server Development https://genai.owasp.org/resource/a-practical-guide-for-secure-mcp-server-development/
[9] CheatSheet – A Practical Guide for Securely Using Third-Party MCP Servers 1.0 https://genai.owasp.org/resource/cheatsheet-a-practical-guide-for-securely-using-third-party-mcp-servers-1-0/
[10] GenAI Security Industry Framework Crosswalk https://genai.owasp.org/resource/genai-security-industry-framework-crosswalk/
[11] OWASP AIBOM Generator https://genai.owasp.org/resource/owasp-aibom-generator/