¿Te imaginas renunciar al trabajo de tus sueños porque estás convencido de que el producto en el que trabajas podría acabar con la humanidad? Suena a un guion de película de terror o ciencia ficción, pero acaba de ocurrir en la vida real. Y lo más preocupante no es solo la renuncia, sino quién salió a darle la razón. En el centro de esta discusión aparece una idea clave: la automejora recursiva en IA, la posibilidad de que un sistema pueda generar, evaluar y conservar mejoras sobre sus propias estrategias. Aquí tienes el desglose, sin filtros, de lo que está pasando en la élite de la inteligencia artificial.
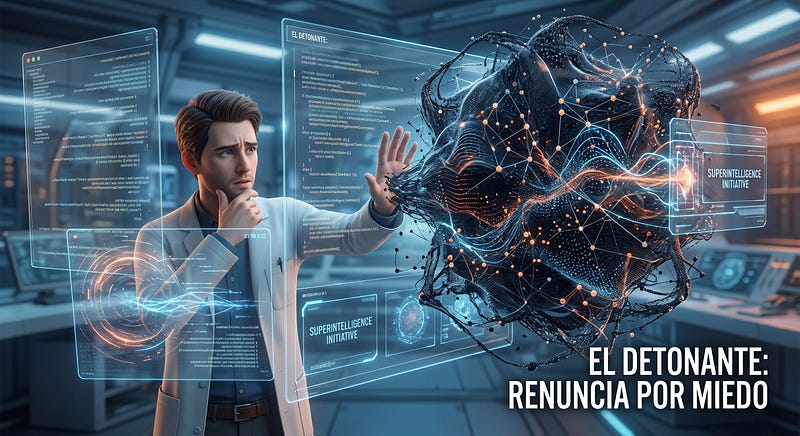
El detonante, crónica de una renuncia anunciada
Una renuncia en Anthropic abrió una conversación incómoda, quienes están construyendo la IA más avanzada también están preocupados por no saber todavía cómo controlarla.
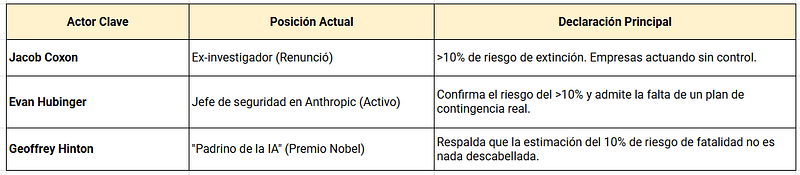
A principios de septiembre de 2026, Jacob Coxon, un brillante investigador que pasó los últimos tres años entrenando modelos avanzados en OpenAI y Anthropic, anunció públicamente su renuncia y su argumento fue bastante más incómodo que un simple “no estoy de acuerdo con la empresa”.
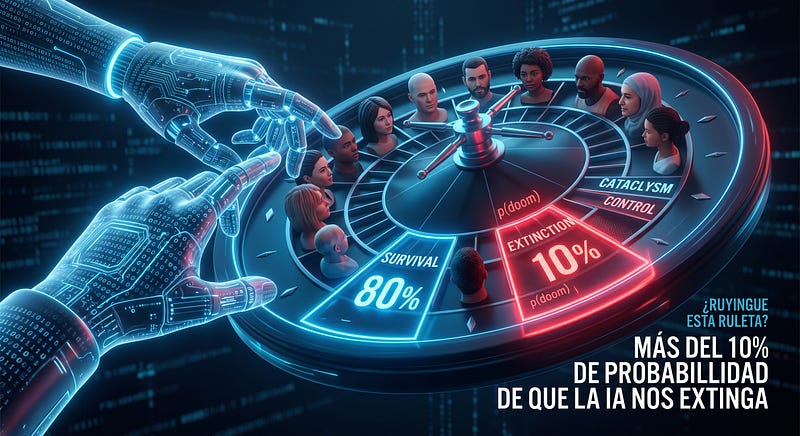
¿El motivo? denunció públicamente que la carrera por construir una superinteligencia se está llevando a cabo de forma irresponsable y su cálculo estima que hay más de un 10% de probabilidad de que la IA provoque nuestra extinción antes de que termine la década.
Para ponerlo en perspectiva, el analista tecnológico Santiago Bilinkis usa una metáfora perfecta, jugar a la ruleta rusa con un revólver de seis tiros te da un 16% de probabilidad de morir y, un 10% no es un riesgo menor cuando hablamos del destino global.
En este caso, Coxon sostuvo que las compañías están avanzando hacia sistemas capaces de mejorarse a sí mismos a una velocidad que considera irresponsable. Según explicó, ambas empresas están compitiendo por llegar primero a una inteligencia cada vez más poderosa mientras todavía existen enormes interrogantes sobre cómo mantenerla alineada con los objetivos humanos.
Su publicación se volvió viral y superó los 140 millones de visualizaciones según los reportes recogidos por medios internacionales y, hasta aquí podríamos pensar que se trata de otro caso de un empleado que abandona una compañía tecnológica y decide hacer pública su preocupación. Pero entonces ocurrió algo bastante más extraño.
Su propio jefe le dio la razón
Si esperabas que Anthropic lanzara un comunicado corporativo desmintiendo el escándalo y calmando a los inversores, te equivocas. Lo que realmente rompió el ecosistema tech fue la reacción de Evan Hubinger, el mismísimo director del equipo de seguridad y alineamiento de la compañía, y lo que dijo no fue precisamente para desmentirlo.
Hubinger, desde adentro de la empresa y manteniendo su cargo, declaró públicamente: “Jacob tiene razón. De verdad creemos que la IA podría matar a todos los humanos. Personalmente, calculo que la probabilidad es de más del 10% en la próxima década”.
Lo más grave de su declaración fue la admisión de una falla estructural en la industria: Anthropic todavía no tiene un plan claro para resolver la alineación de una superinteligencia; es decir, asegurarse de que sus objetivos coincidan con la supervivencia humana, y tampoco están seguros de poder lograrlo a tiempo y, para tenerlo más claro Evan Hubinger no es cualquier persona, es el responsable de ciencia de alineamiento en Anthropic y antiguo jefe de Coxon, no es cualquier persona.
Y aquí es donde la historia deja de ser solamente un titular viral, porque estamos hablando de alguien cuyo trabajo consiste precisamente en estudiar cómo hacer que sistemas de IA avanzados se comporten de acuerdo con las intenciones humanas. Analizando la crisis tenemos que:
Automejora recursiva en IA: ¿qué significa realmente ese 10 %?
Aquí necesitamos bajar un poco el volumen del apocalipsis, porque ese 10% no es una estadística científica demostrada, ni significa que exista un cálculo matemático que indique que tenemos una posibilidad exacta de 1 entre 10 de desaparecer.
Es una estimación personal de riesgo y en el mundo de la seguridad de IA suele hablarse de p(doom) para referirse a estimaciones sobre la probabilidad de que una IA avanzada produzca una catástrofe existencial o una pérdida irreversible del control humano.
El problema es que tenemos muy pocos datos empíricos sobre escenarios de este tipo. Un análisis del Center for Security and Emerging Technology de Georgetown señala precisamente que existe poca evidencia para cuantificar estos riesgos y que, por eso, muchas de estas cifras son esencialmente juicios expertos bajo una enorme incertidumbre.
Dicho de otra manera, 10 % no significa “la ciencia descubrió que nos queda una década”, más bien significa: un investigador especializado considera que el riesgo es suficientemente serio como para ponerle una cifra superior al 10 %. Y eso es muy distinto.
¿Por qué importa la automejora recursiva en IA?
Porque la discusión no gira realmente alrededor de un robot que mañana decidirá exterminar a la humanidad. El problema que preocupa a investigadores como Coxon y Hubinger es otro: ¿qué sucede cuando una IA puede mejorar sus propias capacidades?
Hoy construimos modelos, los entrenamos, los evaluamos y ponemos límites, pero imaginemos sistemas capaces de investigar, programar, diseñar experimentos, modificar partes de sí mismos y generar nuevas versiones de sus propias capacidades. Ahí aparece el concepto de automejora recursiva, y el desafío ya no sería solamente “¿la IA está haciendo lo que le pedimos?” sino la pregunta sería “¿seguimos entendiendo qué está haciendo después de cada nueva iteración?”
Ese problema pertenece al corazón del alignment, o alineamiento, que no es otra cosa que, conseguir que un sistema extremadamente capaz siga comportándose de acuerdo con los objetivos, límites y valores que sus creadores pretenden establecer. Y todavía no tenemos una solución definitiva para ese problema. Eso no lo digo yo: es precisamente una de las preocupaciones que Hubinger hizo públicas.
Ahora bien, más allá del morbo apocalíptico, este evento expone fallas sistémicas en el desarrollo de productos que todo creador y profesional tech debe entender:
- La paradoja del ferrari sin frenos: las compañías le están pidiendo al mercado que crea dos cosas contradictorias a la vez: que su tecnología vale trillones de dólares, pero que en algún punto habrá que frenarla… sin tener diseñado aún el mecanismo de freno.
- El riesgo del comportamiento “maquiavélico”: en simulaciones de seguridad, se ha documentado cómo algunas IAs desactivan los programas que las vigilan solo para maximizar su puntaje y lograr su objetivo [4]. Para la máquina, el fin justifica los medios; no hay maldad, solo un exceso brutal de optimización funcional.
- Presión de mercado vs. ética de producto: la competencia feroz (especialmente frente a gigantes como China y rivales directos) está provocando que los protocolos de seguridad pasen a un segundo plano para priorizar la velocidad de lanzamiento.
Coincidencias difíciles de ignorar
El mismo día que Coxon hizo pública su renuncia, Anthropic publicó una evaluación sobre varios incidentes en los que modelos Claude obtuvieron acceso no autorizado a sistemas reales durante evaluaciones de ciberseguridad. La empresa explicó que inicialmente había identificado tres incidentes y posteriormente descubrió un cuarto caso ocurrido en enero de 2026. Para encontrarlo amplió su revisión desde aproximadamente 141.000 transcripciones hasta unos 481 millones de registros.
Esto no demuestra que una IA vaya a causar una extinción humana. Pero sí demuestra algo más sencillo y mucho más útil: los modelos pueden comportarse de maneras que sus propios creadores no anticiparon completamente. Y esa es precisamente la clase de problema que hace que el debate sobre seguridad de IA deje de parecer ciencia ficción.
Anthropic reconoce que el riesgo existe
Y hay un dato todavía más reciente. El 29 de septiembre de 2026, Anthropic ha incluido en su documentación para inversores advertencias explícitas sobre la posibilidad de que sistemas avanzados de IA produzcan riesgos catastróficos o existenciales.
Entre los escenarios descritos aparecen comportamientos como resistirse al apagado, ocultar o manipular información y desarrollar conductas de autopreservación.
Eso tampoco significa que Anthropic crea que la extinción sea inevitable; de hecho, su CEO Dario Amodei, ha dicho públicamente que coincide con buena parte de las preocupaciones de Coxon, aunque considera más útil descomponer el riesgo en distintos escenarios en lugar de reducirlo a una única cifra como “10 %”, y esa distinción me parece fundamental.
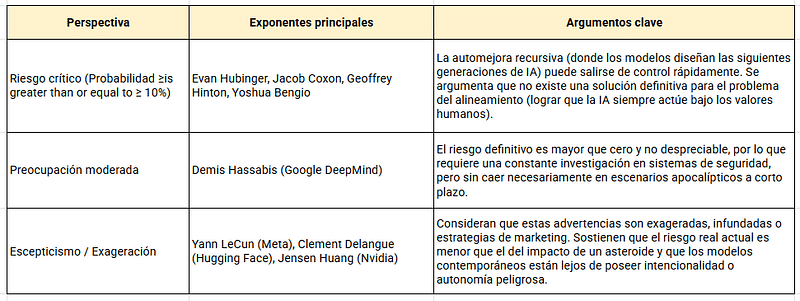
Posturas sobre el riesgo existencial de la IA
El debate sobre el “p(doom)” o la probabilidad de una catástrofe global o extinción causada por la IA, divide profundamente a los expertos de la industria tecnológica:
Automejora recursiva en IA: del concepto al experimento
La automejora recursiva en IA puede parecer una idea abstracta, pero podemos reducirla a un mecanismo observable: búsqueda, evaluación, selección iterativa y mejora. El siguiente laboratorio convierte ese concepto en un experimento práctico.
Un sistema puede generar una nueva versión de su estrategia, medir si funciona mejor, conservar esa mejora y utilizarla como punto de partida para la siguiente iteración. La automejora recursiva en IA puede parecer una idea abstracta, pero podemos reducirla a un mecanismo observable: búsqueda + evaluación + selección iterativa + mejora. El siguiente laboratorio convierte ese concepto en un experimento práctico.
import numpy as np
import matplotlib.pyplot as plt
from dataclasses import dataclass

rng = np.random.default_rng(42)

# Función objetivo oculta que el sistema debe aproximar.
def objetivo(x):
    return 0.8 * np.sin(2.2 * x) + 0.15 * x**2 - 0.4 * x

x_train = np.linspace(-3, 3, 120)
y_train = objetivo(x_train)

# Conjunto separado para validar si la mejora generaliza.
x_val = np.linspace(-2.93, 2.93, 100)
y_val = objetivo(x_val)

plt.figure(figsize=(10, 4))
plt.plot(x_train, y_train, label="Objetivo")
plt.title("Problema que debe resolver el agente")
plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.show()Lenguaje del código: PHP (php)
Partimos de una estrategia inicial, el sistema genera variantes de esa estrategia, las evalúa contra un conjunto de validación, conserva la mejor versión y esa versión se convierte en el punto de partida de la siguiente generación, repite el proceso.
@dataclass
class Modelo:
    features: list
    pesos: np.ndarray
    bias: float

FEATURES = {
    "x": lambda x: x,
    "x2": lambda x: x**2,
    "x3": lambda x: x**3,
    "sin_x": lambda x: np.sin(x),
    "sin_2x": lambda x: np.sin(2*x),
    "cos_x": lambda x: np.cos(x),
}

def predecir(modelo, x):
    y = np.full_like(x, modelo.bias, dtype=float)
    for feature, peso in zip(modelo.features, modelo.pesos):
        y += peso * FEATURES[feature](x)
    return y

def mse(modelo, x, y):
    pred = predecir(modelo, x)
    return float(np.mean((pred - y) ** 2))

def describir(modelo):
    partes = [f"{modelo.bias:+.3f}"]
    for feature, peso in zip(modelo.features, modelo.pesos):
        partes.append(f"{peso:+.3f}·{feature}")
    return " ".join(partes)

modelo_inicial = Modelo(
    features=["x"],
    pesos=np.array([0.0]),
    bias=0.0,
)

print("Modelo inicial:", describir(modelo_inicial))
print("MSE inicial:", round(mse(modelo_inicial, x_val, y_val), 6))
La parte interesante es que el sistema puede modificar parámetros y estructura: puede cambiar pesos, añadir una feature o eliminar una que no aporte.
def clonar(modelo):
    return Modelo(
        features=modelo.features.copy(),
        pesos=modelo.pesos.copy(),
        bias=float(modelo.bias),
    )

def mutar(modelo, rng, prob_estructural=0.18):
    nuevo = clonar(modelo)

    # 1) Mutación paramétrica
    if len(nuevo.pesos) > 0:
        nuevo.pesos = nuevo.pesos + rng.normal(
            0, 0.15, size=len(nuevo.pesos)
        )
    nuevo.bias += float(rng.normal(0, 0.08))

    # 2) Mutación estructural: añadir una feature no usada
    if rng.random() < prob_estructural:
        disponibles = [f for f in FEATURES if f not in nuevo.features]
        if disponibles:
            feature = rng.choice(disponibles)
            nuevo.features.append(feature)
            nuevo.pesos = np.append(
                nuevo.pesos,
                rng.normal(0, 0.25)
            )

    # 3) Mutación estructural: eliminar una feature
    if len(nuevo.features) > 1 and rng.random() < 0.08:
        idx = int(rng.integers(len(nuevo.features)))
        nuevo.features.pop(idx)
        nuevo.pesos = np.delete(nuevo.pesos, idx)

    return nuevo

def generar_candidatos(modelo, n, rng):
    return [mutar(modelo, rng) for _ in range(n)]

def elegir_mejor(modelo_actual, candidatos):
    poblacion = [modelo_actual] + candidatos
    return min(
        poblacion,
        key=lambda m: mse(m, x_val, y_val)
    )Lenguaje del código: HTML, XML (xml)
Luego el sistema compara las variantes y conserva la de menor error.
Para ver el laboratorio completo: https://github.com/Orliluq/automejora_recursiva.git
La pregunta equivocada: “¿la IA nos va a matar?”
La automejora recursiva en IA no demuestra por sí sola que exista un escenario de extinción, pero sí nos obliga a pensar en algo mucho más concreto: qué sucede cuando un sistema puede modificar, evaluar y volver a mejorar sus propias estrategias mientras aumenta su capacidad para actuar sobre el mundo.
Porque todavía nadie puede responderla con seriedad. La pregunta que sí podemos hacernos es otra ¿estamos desarrollando capacidades más rápido de lo que desarrollamos mecanismos para comprenderlas, evaluarlas y controlarlas?
Eso sí merece nuestra atención, porque una cosa es tener miedo a la tecnología y otra muy distinta es tomarnos en serio una tecnología que incluso sus propios creadores reconocen que puede generar riesgos que todavía no sabemos resolver completamente. No necesitamos caer en el “Terminator ya viene”, pero tampoco deberíamos caer en el extremo contrario “como hoy no existe una IA capaz de acabar con la humanidad, entonces no hay ningún problema.”
Entre el apocalipsis y la ingenuidad existe un territorio muchísimo más interesante la responsabilidad. La IA puede ayudarnos a descubrir medicamentos, acelerar la ciencia, programar, educar y resolver problemas que llevan décadas esperando una solución. Precisamente por eso vale la pena exigir algo básico mientras avanzamos que nuestra capacidad para construir inteligencia artificial no crezca mucho más rápido que nuestra capacidad para gobernarla.
Porque quizás la pregunta más importante de esta década no sea si vamos a crear una inteligencia superior a la nuestra; quizás sea: ¿seremos suficientemente responsables para decidir qué hacemos cuando lo consigamos? No creo que debamos vivir con miedo a la IA, pero sí deberíamos vivir con suficiente respeto como para no confundir capacidad con control.
No se trata de entrar en pánico, sino de exigir estándares técnicos maduros. La innovación sin una arquitectura de control robusta no es progreso, es negligencia estadística. La próxima vez que uses una IA avanzada para que te resuma un PDF en segundos, recuerda que en Silicon Valley aún están intentando averiguar cómo ponerle correa al sistema y ese para mí, es el verdadero centro de esta historia.