No basta con abrir el modelo. El sistema que se construye a su alrededor también tiene que poder verificarse.
Empecé mi carrera en el mundo de la informática cuando internet todavía no era un conjunto de plataformas en las que pasar el rato, sino una infraestructura por explorar, entender y ayudar a construir. No había cursos en vídeo que se vendieran con una cuenta atrás, ni influencers tecnológicos, ni asistentes de IA que respondieran con seguridad a preguntas sobre las que no tenían ni idea. Había documentación técnica, listas de correo, grupos de noticias, preguntas frecuentes, repositorios y gente que compartía libremente lo que había aprendido.

Como gran parte de mi formación fue autodidacta, ese conocimiento compartido no solo me ayudó a adquirir nuevas habilidades, sino que también marcó mi identidad profesional. Con los años, intenté devolver algo de lo que había recibido: escribiendo guías sobre internet y realidad virtual, cuando ambos mundos todavía parecían territorios por explorar; manteniendo preguntas frecuentes sobre Linux; colaborando en proyectos de código abierto y dedicándome al periodismo tecnológico. Durante un tiempo, incluso fui lo que entonces se llamaba, sin ningún tipo de ironía, un evangelista del código abierto.
Mirar atrás ahora me produce cierta nostalgia. No por los módems ruidosos ni por tener que compilar configuraciones a mano, sino por la idea de que el conocimiento técnico podía ser un bien compartido: algo que cualquiera podía recibir, mejorar y volver a poner en circulación. Aquella idea no era solo un gesto generoso. Era uno de los mecanismos que hacían posible la innovación.
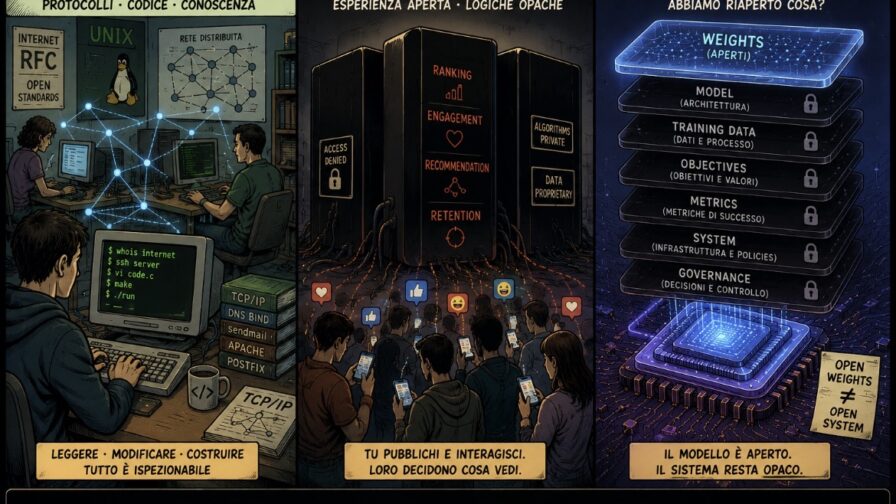
Este artículo recorre el camino desde el internet abierto en el que crecí, pasando por los algoritmos cerrados de las grandes plataformas, hasta llegar a los modelos de IA con pesos abiertos de hoy. A partir de ahí, quiero cambiar el enfoque de la pregunta: no se trata solo de saber hasta qué punto es abierto un modelo, sino de comprobar hasta qué punto se puede verificar el sistema que se construye a su alrededor. Utilizaré la IA en la educación y un marco de trabajo llamado L×M×C como ejemplos concretos, para terminar con una propuesta más amplia sobre cómo aplicar la gobernanza de código abierto a los sistemas de IA.
Una red abierta, gobernada por algoritmos cerrados
Internet creció gracias a protocolos públicos, estándares interoperables, software abierto y comunidades distribuidas. Nadie necesitaba el permiso de un propietario central para crear un nuevo servicio basado en HTTP, TCP/IP, SMTP o DNS. Y no solo eran abiertos los protocolos: también lo era el software que los implementaba.
La apertura no eliminó los conflictos ni impidió que aparecieran grandes actores dominantes, pero evitó que una sola organización pudiera decidir unilateralmente cómo debía evolucionar toda la red.
Con la llegada de las grandes plataformas sociales, las cosas cambiaron. Los fundamentos técnicos de internet siguieron siendo, en gran medida, abiertos, mientras que los sistemas que decidían qué veíamos, qué contenidos ganaban visibilidad, qué relaciones se nos sugerían y qué comportamientos se premiaban se volvieron propietarios, opacos y cambiantes.
Una red construida sobre protocolos abiertos acabó gobernada por sistemas de decisión cerrados. Y esos sistemas no se limitaban a organizar información: también moldeaban el entorno cognitivo y social en el que millones de personas pasan cada vez más tiempo.
El caso de Cambridge Analytica hizo visible una parte de este problema para el gran público. No fue simplemente una consecuencia del código cerrado, sino una demostración de cómo los datos personales, los sistemas de elaboración de perfiles, la publicidad y la lógica opaca de las plataformas podían combinarse para influir a gran escala en la política y la sociedad.
Desde entonces, se han acumulado pruebas sobre los efectos negativos que ciertos patrones de uso de las redes sociales pueden tener en los jóvenes. El director general de Salud Pública de Estados Unidos ha citado datos que indican que los adolescentes que pasan más de tres horas al día en redes sociales tienen aproximadamente el doble de riesgo de sufrir problemas de salud mental. Estudios más recientes también apuntan a efectos importantes sobre la ansiedad, la depresión y el bienestar, especialmente entre las chicas.
El problema ya no se limita al ámbito de la investigación. En 2026, jurados estadounidenses declararon responsables a Meta y a Google/YouTube en casos relacionados con la protección de menores, reconociendo su responsabilidad por elementos de diseño como el desplazamiento infinito, la reproducción automática, las notificaciones y los algoritmos de recomendación.
Ya hemos visto qué ocurre cuando los sistemas algorítmicos opacos se optimizan para maximizar la interacción de millones de menores. Repetir ese experimento con la IA, una tecnología todavía más presente y capaz de interactuar directamente con ellos, sería una decisión poco sensata.
Los legisladores europeos han empezado a centrarse en la arquitectura de las plataformas, no solo en sus contenidos. El Reglamento de Servicios Digitales (DSA) exige que las plataformas accesibles a menores protejan su bienestar, privacidad y seguridad, y prohíbe la publicidad personalizada dirigida a niños. En julio de 2025, la Comisión Europea publicó directrices específicas para la protección de menores que también abordan los sistemas de recomendación y el diseño de las plataformas.
La cuestión no es que los algoritmos cerrados sean necesariamente perjudiciales y los abiertos, automáticamente éticos. Esa conclusión sería tranquilizadora, sencilla y falsa. El verdadero problema es que llevamos años permitiendo que sistemas diseñados para maximizar la atención y la interacción influyan en el comportamiento de los menores sin que se pueda comprobar públicamente qué beneficios han generado, qué riesgos implican o qué métricas han guiado su evolución.
Con el aprendizaje automático, el código ya no basta
En el software tradicional, el código fuente describe de forma bastante directa cómo se comporta un programa. No siempre es sencillo de entender, pero al menos las instrucciones están disponibles.
Con el aprendizaje automático, esa relación se debilita. El comportamiento ya no depende únicamente del código, sino también de los datos de entrenamiento, la arquitectura del modelo, los procedimientos de entrenamiento, los pesos aprendidos, los criterios de selección de datos, el ajuste fino, las métricas de evaluación y un sinfín de decisiones tomadas durante el desarrollo.
Con los grandes modelos de lenguaje, el sistema se vuelve todavía más complejo. Su comportamiento puede depender de los datos y procedimientos de preentrenamiento, la arquitectura y los pesos del modelo, las instrucciones del sistema, las técnicas de alineamiento, los filtros de moderación, las herramientas externas a las que puede acceder, la lógica que coordina sus componentes, los criterios de evaluación y las actualizaciones continuas del proveedor.
Publicar el código de la aplicación que llama al modelo solo permite ver una pequeña parte del sistema. Es como publicar el panel de control de un coche y afirmar que con eso ya se ha documentado su motor, su transmisión y sus sistemas de control.
Publicar únicamente el código fuente ya no es suficiente.
Tener los pesos abiertos no siempre significa tener código abierto
La popularidad de los modelos de pesos abiertos ha generado cierta confusión. Publicar los pesos de un modelo es importante: permite ejecutarlo en una infraestructura propia, analizarlo, ajustarlo y desarrollar nuevas soluciones a partir de él sin depender de la API de un proveedor.
Pero poder descargar los pesos no significa que puedas entender cómo se ha construido el modelo. Puede que no estén disponibles los datos de entrenamiento, los criterios de selección, el código utilizado para entrenarlo, los procedimientos de alineamiento o los resultados de las evaluaciones. Además, las licencias suelen incluir restricciones de uso.
La Open Source Initiative (OSI) abordó esta cuestión con la definición de IA de código abierto 1.0 (Open Source AI Definition 1.0). Según esta definición, un sistema solo puede considerarse de código abierto si garantiza la libertad de utilizarlo, estudiarlo, modificarlo y compartirlo. Para ello, es necesario acceder a los materiales y recursos realmente utilizados para poder introducir cambios en el sistema.
Disponer de los pesos puede ser parte de esa apertura, pero no basta por sí solo.
Una comparación concreta ayuda a entenderlo. Meta publica los pesos de sus modelos Llama, pero no el código de entrenamiento ni los datos de preentrenamiento. Además, su licencia restringe determinados usos cuando se superan los 700 millones de usuarios activos mensuales, una condición que la definición de IA de código abierto excluye expresamente de su primera libertad.
OLMo 3, del Allen Institute for AI, sigue un camino diferente: publica los pesos, el código completo de entrenamiento, los puntos de control intermedios y el conjunto de datos de preentrenamiento Dolma 3, con aproximadamente seis billones de tokens, todo ello bajo la licencia Apache 2.0.
Con Llama, un investigador independiente puede ejecutar el modelo, pero no reproducirlo ni verificar cómo se construyó. Con OLMo, puede hacer ambas cosas.
La contradicción se hace todavía más evidente al observar los modelos de pesos abiertos más competitivos del momento. Kimi, de Moonshot AI; GLM, de Z.ai; y Qwen, de Alibaba, se han acercado mucho a los modelos propietarios en tareas de programación y razonamiento en 2026.
Están disponibles gratuitamente, pero ninguno publica de forma sistemática el código de entrenamiento y los detalles de los datos en el formato que exige la definición de la OSI. Mientras tanto, OLMo, que sí cumple esos requisitos, sigue siendo un producto de nicho.
Parece que el ecosistema recompensa mucho más el «gratis como una cerveza» (free as in beer) que el «libre como en libertad» (free as in speech).
Abrir el modelo no basta para abrir el sistema
Incluso un modelo de código abierto de verdad no garantiza que la aplicación construida sobre él sea transparente, segura o esté alineada con los intereses de sus usuarios.
Un sistema de IA se compone de muchas capas: el modelo base; los datos y procedimientos utilizados para adaptarlo; las instrucciones que determinan su comportamiento; la aplicación en la que se integra; los objetivos que se le asignan; las métricas con las que se evalúa; los procesos para detectar errores y sus consecuencias; y la gobernanza que determina los cambios, las prioridades y las decisiones de compromiso entre distintos objetivos.
Un modelo abierto puede formar parte de un sistema que optimice criterios completamente opacos. Del mismo modo, un modelo propietario puede impulsar una aplicación que explique con claridad sus objetivos, limitaciones, métricas y resultados de evaluación.
La apertura debe abarcar todo el sistema sociotécnico, no solo uno de sus componentes.
Aquí es donde el código abierto se encuentra con la gobernanza. Ya no basta con preguntar: «¿Puedo ver el código?». También debemos plantearnos otras cuestiones:
- ¿Qué intenta optimizar el sistema?
- ¿Quién ha elegido ese objetivo?
- ¿Qué datos y métricas se utilizan para medirlo?
- ¿Qué posibles efectos negativos se han tenido en cuenta?
- ¿Quién puede verificar los resultados?
- ¿Quién puede cuestionar las decisiones de diseño?
- ¿Cómo se gestionan los cambios?
- ¿Qué ocurre cuando los intereses de los usuarios entran en conflicto con los del proveedor?
Estas preguntas son todavía más importantes en ámbitos como la sanidad, el empleo, el crédito, la justicia y la educación.
Cuando el algoritmo entra en el aula
En las escuelas es donde la diferencia entre «rendimiento» y «beneficio» se hace más evidente.
Un sistema de IA generativa puede ser muy eficaz a la hora de dar respuestas correctas, resumir textos, resolver problemas o producir textos bien redactados. Pero el objetivo de la educación no es simplemente obtener una respuesta correcta.
Un estudiante puede entregar un trabajo excelente sin haber desarrollado ninguna comprensión real del tema. Obtiene el resultado intelectual sin recorrer el proceso que debería haberle permitido alcanzarlo.
Esto no es un efecto secundario. Es una consecuencia directa del objetivo para el que se diseña buena parte de la IA de propósito general: ser útil, responder rápido y reducir el esfuerzo.
En el trabajo profesional, esto puede aumentar la productividad. En el aprendizaje, eliminar sistemáticamente el esfuerzo puede acabar eliminando el propio mecanismo mediante el cual se desarrollan la comprensión, la autonomía y la capacidad de aplicar lo aprendido a situaciones nuevas.
Por eso, la verdadera pregunta no es solo qué modelo utilizar en las escuelas, sino qué idea del aprendizaje lleva incorporada el sistema.
Si esa idea permanece implícita y es propiedad exclusiva del proveedor, docentes, familias e instituciones solo pueden valorar lo que ven en la superficie: la facilidad de uso, la rapidez de respuesta, el diseño de la interfaz o, quizá, la precisión de la información.
No pueden comprobar qué está intentando optimizar realmente el sistema desde el punto de vista cognitivo.
Un marco abierto para una IA educativa que se pueda cuestionar
Este es el problema que aborda L×M×C, un marco de trabajo que desarrollé como base teórica de Proxima ZSP, un sistema de tutoría socrática basado en IA.
El marco, su manifiesto y su prepublicación académica están disponibles públicamente bajo la licencia CC BY 4.0 en lmc.proxima-zsp.it.
En lugar de evaluar la calidad de una interacción únicamente por la corrección de la respuesta final, el marco tiene en cuenta tres dimensiones:
- Profundidad del razonamiento: hasta qué punto el estudiante desarrolla y construye su razonamiento.
- Metacognición: la capacidad del estudiante para observar y regular su propio pensamiento.
- Consolidación: si lo aprendido se afianza y puede aplicarse a otras situaciones.
El objetivo de Proxima ZSP no es responder por el estudiante, sino intervenir mediante preguntas, peticiones de explicación y reformulaciones que le ayuden a construir su propio camino hacia la solución.
La cuestión no es afirmar que este marco sea la respuesta definitiva. Esa afirmación encajaría bastante mal con la propia lógica de la apertura. Lo importante es que es público, se puede criticar y se puede modificar.
Un docente puede cuestionar cómo se define la profundidad del razonamiento. Un investigador puede proponer métricas mejores. Un desarrollador puede crear una implementación diferente. Un centro educativo puede decidir que algunos criterios no encajan con las necesidades de sus estudiantes.
La apertura no garantiza que el marco sea correcto. Garantiza algo más importante: que nadie tenga que aceptar su validez por fe.
En mi propio caso, esta apertura ya ha tenido una consecuencia concreta. Al analizar la métrica de metacognición, descubrí que mezclaba dos cosas distintas: la reflexión espontánea y la capacidad de reflexionar cuando alguien te lo pide. Por eso, estoy redefiniendo la métrica antes de comenzar el ensayo controlado.
Ese es precisamente el tipo de proceso que debería aplicarse a todos los sistemas de IA: sacar los problemas a la luz, corregir las métricas que no funcionan y permitir que otras personas verifiquen los resultados.
Del derecho a ver el código al derecho a entender el sistema
La transparencia algorítmica suele tratarse como una cuestión técnica: documentación, auditorías, acceso al código y explicabilidad. Pero la transparencia real empieza con una pregunta anterior: ¿qué beneficio afirma generar el sistema?
Como mínimo, cualquier sistema algorítmico dirigido a menores debería hacer públicos los siguientes aspectos:
- El beneficio que se espera conseguir.
- La población a la que va dirigido.
- Las métricas utilizadas para medir ese beneficio.
- Las pruebas empíricas disponibles.
- Los riesgos previsibles.
- Los grupos que podrían ser especialmente vulnerables.
- Los resultados de evaluaciones independientes.
- Cómo se actualiza el sistema.
- Los mecanismos que permiten a docentes, familias e investigadores cuestionar su funcionamiento.
No debería bastar con demostrar que una tecnología no incumple formalmente una norma. Quien introduzca un sistema en la vida de los niños debería tener que explicar qué beneficio pretende generar y demostrar cómo va a medirlo a lo largo del tiempo.
El Reglamento de IA de la UE ya exige transparencia, gestión de riesgos y documentación para determinadas categorías de alto riesgo. Por su parte, el Reglamento de Servicios Digitales obliga a las grandes plataformas a evaluar y mitigar los riesgos sistémicos, incluidos los que afectan a los menores.
Son pasos importantes, pero el debate debe ir más allá de «evitar daños demostrables» y avanzar hacia los «beneficios demostrables».
Entre no causar un daño evidente y producir un beneficio real hay un espacio enorme. Y es precisamente en ese espacio donde opera hoy gran parte de la tecnología educativa.
La gobernanza de código abierto como infraestructura pública
La gobernanza de código abierto aplicada a la IA no significa obligar a todas las empresas a publicar indiscriminadamente sus datos, secretos comerciales y propiedad intelectual.
Significa construir sistemas en los que los objetivos, los criterios de evaluación, las limitaciones y los procesos de toma de decisiones puedan examinarse. Y permitir que la comunidad participe no solo en la escritura del software, sino también en la definición de lo que ese software debería hacer.
No partimos de cero.
Las Model Cards, propuestas en 2019, establecen una forma estandarizada de documentar los datos, las limitaciones y los usos previstos de un modelo. La definición de IA de código abierto de la OSI, mencionada anteriormente, persigue un objetivo similar.
Desde 2023, el Foundation Model Transparency Index de Stanford evalúa la transparencia de los principales desarrolladores de modelos. Los resultados de 2025 son reveladores: la puntuación media cayó de 58 a 40 sobre 100 en un solo año, revirtiendo los avances anteriores. Meta pasó de 60 a 31 puntos y Mistral, de 55 a 18. Las empresas chinas, evaluadas por primera vez en 2025, quedaron en la mitad inferior de la clasificación.
Las herramientas para medir la transparencia ya existen y están dando resultados. Sin embargo, la transparencia de la industria está empeorando, no mejorando.
El problema no es que falten métricas, sino que nadie está obligado a obtener una buena puntuación para seguir operando.
Además, necesitamos protocolos públicos de evaluación, pruebas de referencia (benchmarks) que midan algo más que el rendimiento bruto, conjuntos de datos documentados y verificables, herramientas de auditoría independientes, especificaciones abiertas para sistemas de gran impacto, comunidades multidisciplinares en las que participen desarrolladores, investigadores, docentes, abogados y usuarios, y mecanismos de gobernanza que permitan sacar a la luz los conflictos de intereses y las decisiones tomadas.
La comunidad del código abierto no necesita entrenar en un garaje el próximo modelo fundacional de cien mil millones de parámetros. Para eso harían falta cantidades poco habituales de GPU, energía y capital.
Pero sí puede abrir la capa en la que los modelos se convierten en sistemas sociales, educativos y de toma de decisiones. Puede crear herramientas para comprobar lo que estos sistemas afirman hacer. Puede definir métricas alternativas a las elegidas por los proveedores. Puede desarrollar implementaciones que no estén subordinadas a maximizar la interacción, recopilar datos o depender de una única plataforma.
Y, sobre todo, puede evitar que la complejidad técnica se utilice como excusa para mantener las decisiones fuera del alcance del público.
Abrir aquello que ejerce poder
El código abierto nació de una idea sencilla: cualquiera que utilice un programa debería poder estudiarlo, modificarlo y compartirlo.
Hoy, el software no se limita a ejecutar instrucciones. Selecciona información, predice comportamientos, orienta decisiones, personaliza entornos y media en una parte cada vez mayor de nuestra experiencia de la realidad.
Por eso, abrir el código ya no es suficiente. Cuando un sistema ejerce poder sobre las personas, necesitamos entender qué objetivos persigue, qué supuestos incorpora, cómo se evalúa y quién puede cambiar su comportamiento.
Por eso, el marco L×M×C es abierto. No porque sea perfecto, sino para que otras personas puedan verificarlo, criticarlo, adoptarlo, transformarlo o demostrar en qué falla.
Es una invitación real a la comunidad técnica, científica y educativa: el marco está publicado bajo la licencia CC BY 4.0 en lmc.proxima-zsp.it.
Léelo, ponlo a prueba y busca sus puntos débiles. Desarrolla una implementación diferente o amplíalo a otro ámbito o grupo de edad.
Contribuir a modelos de gobernanza en los que la apertura sea una propiedad verificable, y no una simple frase de marketing, empieza con un enlace que cualquiera puede abrir hoy mismo.
Y también es una invitación a los legisladores: cuando un sistema algorítmico se dirige a menores, la transparencia debería ser obligatoria no solo sobre cómo funciona, sino también sobre el beneficio que afirma producir y las pruebas que respaldan esa afirmación.
Internet demostró que una infraestructura abierta puede generar una innovación que va mucho más allá de lo que imaginaron sus creadores. Ahora la IA nos plantea un reto parecido, con consecuencias todavía mayores. No basta con abrir las tecnologías. Tenemos que abrir también las decisiones que convierten esas tecnologías en una fuente de poder.