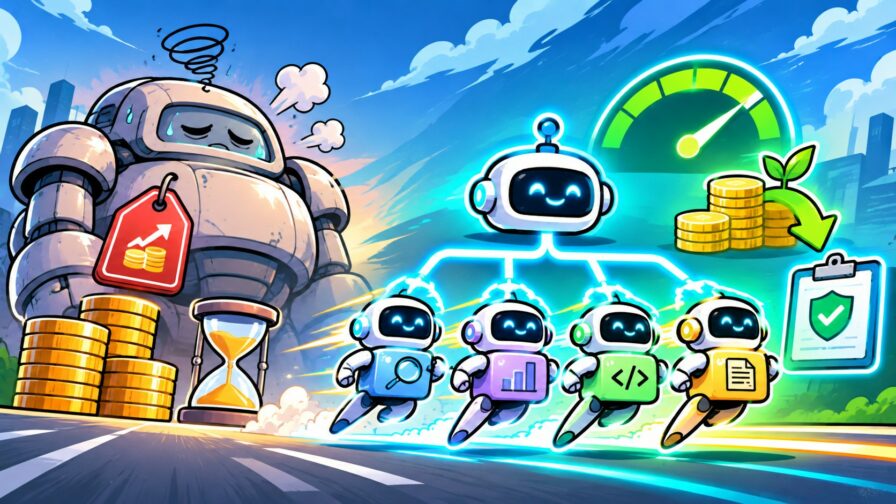
Ogni volta che uno sviluppatore invia un 2 + 2 o un task di formattazione JSON a un modello proprietario da 400 miliardi di parametri, da qualche parte nel mondo una GPU H100 piange e un CFO riceve una notifica di over-budget.
Nel meetup mensile ospitato da ENG (Engineering) grazie ad Andrea Raponi, Daniele Scasciafratte ed Eugenio Petullà hanno smontato pezzo per pezzo la retorica del “modello unico per dominare il mondo”. Il messaggio è chiaro: per scalare prodotti basati su intelligenza artificiale senza farsi dissanguare dai costi di calcolo o schiacciare dai requisiti di compliance europei, bisogna smettere di trattare l’AI come una black-box e iniziare a fare ciò che sappiamo fare meglio: ingegneria del software e dei sistemi.
Il paradosso dell’inferenza: Token, VRAM e la fame di KV Cache
Quando effettuiamo una chiamata a un LLM, il testo viene scomposto dal tokenizer in unità minime. Queste unità vengono convertite in embedding vettoriali ed elaborate dalla GPU. Qui sorge il primo collo di bottiglia sistemico: la KV Cache (Key-Value Cache).
Per evitare di ricalcolare l’attenzione su tutti i token precedenti a ogni singola parola generata in streaming, il motore di inferenza memorizza i tensori delle chiavi e dei valori nella VRAM della scheda video. Più il contesto si allunga (fino al milione di token promesso dal mercato), più la memoria video viene cannibalizzata dalla cache a discapito del throughput dei batch concorrenti:
- Se la KV Cache deve risiedere interamente in memoria video ultra-veloce, la capacità di servire richieste simultanee crolla verticalmente non appena aumentano gli utenti.
- Se si tenta di spostare la cache su disco o storage secondario per contenere i costi, la latenza per token generato rischia di passare da decine di millisecondi a secondi interi.
Richiesta Dev (HTTPS)
──> Tokenizer (scomposizione in sillabe/token)
──> Generazione Embedding Vettoriale
──> GPU Core (Elaborazione Attention)
──> KV Cache (VRAM saturata progressivamente per mantenere il contesto)
vLLM vs SGLang: Due filosofie a confronto
Il livello intermedio che governa tutto questo è il motore di inferenza. Oggi lo standard si gioca su due piattaforme:
- vLLM: Il gigante storico, scritto prevalentemente in Python e sostenuto dai vendor hardware come Nvidia e AMD. Ha introdotto la PagedAttention, un’architettura che modella la memoria video come la memoria virtuale a pagine dei sistemi operativi. È robusto, ma risente di una velocità di iterazione e rilascio legata a una codebase monolitica.
- SGLang: Motore moderno scritto in Rust, basato su RadixAttention. Invece di gestire la cache come un blocco di pagine isolate, struttura la memoria condivisa ad albero/grafo. Nelle architetture multi-turn o nei flussi ad agenti con prompt di sistema identici, riutilizza porzioni enormi di calcolo già effettuato.
Compliance reale e Zero Data Retention: L’AI Act non fa sconti
Un’applicazione enterprise non fallisce solo per latenza; fallisce quando il dipartimento Legal blocca il deploy.
Tra il GDPR e il progressivo dispiegamento dell’EU AI Act, affidarsi a endpoint esteri che riservano nei propri Termini di Servizio il diritto di trattenere i log per il fine-tuning espone le aziende a sanzioni e violazioni del segreto industriale. L’AI Act distingue nettamente tra chi addestra foundation model da zero e chi eroga pura inferenza su modelli open-weights già validati.
Per garantire piena conformità, l’infrastruttura di inferenza deve rispettare pilastri ferrei:
- Data Sovereignty: Server e datacenter localizzati su territorio nazionale ed europeo (come i nodi italiani tra Frosinone e la Lombardia di Regolo/Seeeeb).
- Zero Data Retention (ZDR): Nessuna persistenza di prompt o completion sui dischi dell’infrastruttura. L’unico dato tracciabile è il metadata di consumo (token consumati, modello chiamato, orario) necessario per la fatturazione.
- Prompt Caching Crittografato: Se per ragioni di performance si abilita il caching dei prefissi persistente, questo deve essere cifrato con chiavi univoche per tenant per non rompere la ZDR.
- Impatto ESG & Green Energy: L’inferenza non è gratis nemmeno per l’ambiente; l’utilizzo di infrastrutture alimentate al 100% da fonti rinnovabili, con metriche visibili su grammi di CO2 e milliwatt consumati per prompt, diventa un KPI concreto per i bilanci di sostenibilità.
Dalla cattedrale al cantiere: L’architettura a Sub-Agenti
Inviare un intero task di revisione codice o di analisi architetturale a un modello gigante “generalista” genera bollette insostenibili e risposte annacquate.
L’approccio ingegneristico più efficiente è la suddivisione dei ruoli su modelli specializzati coordinati in asincrono:
┌──> [Sub-Agente 1: Mistral] ──> Analisi critica & Bug finding
[Orchestratore: GLM] ┼──> [Sub-Agente 2: Gemma] ──> UI/UX & Frontend code
└──> [Sub-Agente 3: Qwen] ──> Esecuzione compiti specifici / Core logic
- GLM (es. GLM-5) come Orchestratore: I modelli di taglia superiore gestiscono un contesto ampio senza disperdersi, pianificano le attività, interrogano i sub-agenti e sintetizzano i risultati.
- Mistral (Large) come Reviewer Adversariale: Modello europeo con spiccata competenza analitica e multilingua, particolarmente incline a identificare falle logiche, edge case e violazioni architetturali.
- Qwen (famiglia come Task Executor: Modelli cinesi dall’eccellente rapporto costo/token nell’esecuzione pura del codice. Se gli viene dato un perimetro vincolato (“fai questo refactoring”), lo eseguono senza sbavature. Non vanno però usati come orchestratori aperti, pena allucinazioni strutturali.
- Gemma (31B) come Frontend & UI/UX Specialist: Modello agile ed efficace quando si tratta di impaginare componenti, curare interfacce (ad esempio con Qt o HTML) e comprendere la logica visiva.
Context Engineering: Il caso studio “Linus Torvalds” su smart_ptr di Antirez
Un LLM rilasciato un anno fa è un modello che non conosce le ultime patch, le nuove release dei framework o le pratiche interne del vostro repository. Come si evita il costo proibitivo di fare continuamente fine-tuning dell’hardware? Tramite le Skill modulari iniettate nel contesto sotto forma di file Markdown specializzati.
Un esperimento empirico condotto da Daniele Scasciafratte ne illustra il funzionamento pratico:
- È stata creata una pipeline per processare 38.000 email scritte da Linus Torvalds sulla Linux Kernel Mailing List nel corso di vent’anni.
- Da questo corpus sono state estratte le euristiche di code review di Torvalds, sintetizzate in una “Skill” Markdown riutilizzabile.
- La skill è stata poi applicata alla code review di smallchat, un progetto C++ di Salvatore Sanfilippo (Antirez) composto da una decina di file.
I risultati del benchmark parlano chiaro:
- Senza la Skill: I modelli analizzano la codebase con le euristiche standard, trovando anomalie superficiali.
- Con la Skill iniettata: Modelli come Mistral hanno evidenziato vulnerabilità uniche e puntuali nella gestione della memoria e nei race conditions, superando in profondità di analisi perfino modelli più grandi ma privi del contesto specifico.
- Il paradosso del modello monolitico: Modelli enormi come GLM hanno registrato meno anomalie quando vincolati dalla skill rispetto a runtime intermedi più aggressivi come Mistral, dimostrando che il modello più grande non è automaticamente il migliore per compiti verticali.
Il ROI dello sviluppatore: Come implementarlo da lunedì
Per mettere a terra questa strategia senza riscrivere l’intera codebase applicativa, il punto di partenza è il disaccoppiamento:
- Adottare la compatibilità OpenAI: Non usate SDK proprietari che vi legano mani e piedi a un singolo provider. Sfruttate endpoint compatibili con le API standard (basta puntare l’host a provider europei di inferenza come api.regolo.ai) cambiando solo URL base e token.
- Implementare un Router Dinamico (es. BRICK): Non lasciate al dev la scelta del modello per ogni query[cite: 1]. Usate router semantici open source che classificano la complessità del prompt al volo, inviando le richieste banali a modelli da 9B e riservando i modelli da 120B+ solo ai compiti complessi.
- Modularizzare i Prompt in Skill Versions: Mantenete le istruzioni operative in file Markdown tracciati sotto git. Questo permette di aggiornare la conoscenza dei modelli e mitigare gli errori di sviluppo senza toccare una riga di codice dell’agente.
Smettere di sprecare token non è solo un atto di rispetto verso il bilancio aziendale: è il prerequisito per costruire software con l’AI che sia resiliente, reattivo e conforme alle normative prima che arrivi la prossima notifica del cloud provider.