Estratigrafía de una infraestructura: reconstruir un ISP de 1995 mediante informática forense digital
Hace un tiempo estaba buscando material antiguo para responder a la pregunta de un amigo cuando me encontré con unas carpetas en un NAS que llevaba casi treinta años sin abrir. Eran copias de seguridad y documentación que había creado para Internet Force, el proveedor de Internet (ISP) en el que trabajaba como administrador de sistemas y redes en 1995.
Dentro había configuraciones de routers Cisco, zonas BIND, archivos de Sendmail, configuraciones de XTACACS, scripts, mapas SNMP creados con tkined, archivos /etc/hosts y /etc/networks, configuraciones de routing, documentación operativa e incluso inventarios de hardware, discos y sistemas de archivos de los equipos Sun.
Algunas copias de seguridad estaban dañadas y faltaban otros archivos, probablemente perdidos durante las numerosas migraciones de ordenador por las que habían pasado. Me recordaban a los restos de una gran civilización del pasado: igual que ocurre con los templos antiguos, bastaba con mirar las columnas para hacerse una idea de lo que habían sido.
Al responder a las preguntas de mi amigo me di cuenta de dos cosas. La primera es que aquel material sigue despertando una curiosidad casi irracional en un determinado tipo de personas que, para simplificar, llamaremos geeks. La segunda es que hoy resulta sorprendentemente difícil encontrar una descripción completa de cómo estaba construido y cómo funcionaba realmente un pequeño proveedor de Internet comercial a mediados de los años noventa.
Empecé a seguir las pistas que aparecían en los archivos recuperados. Una dirección IP de un archivo llevaba a un equipo mencionado en otro; una ruta explicaba el camino hasta un POP; una regla de FireWall-1 aclaraba por qué se podía acceder a un servicio desde una red, pero no desde otra.
Algunos documentos mostraban momentos diferentes y, a primera vista, parecían contradecirse. Llegados a ese punto, la comparación con un trabajo arqueológico dejó de ser solo una metáfora curiosa: a partir de aquellos restos podía reconstruir no solo qué máquinas existían, sino cómo funcionaba realmente todo el conjunto.
Así que decidí reconstruir aquella historia comparando los materiales originales con mis propios recuerdos y, cuando hacía falta, utilizando la IA como ayuda puntual para recuperar partes que faltaban o archivos dañados.
El problema era que no tenía una única copia de seguridad completa y coherente, correspondiente a un día concreto de 1995 (o de 1996). No había conservado las copias de seguridad periódicas de aquella época. En su lugar, tenía distintas capas de información: copias que habían sobrevivido a numerosas migraciones de ordenador, configuraciones actualizadas en momentos posteriores (y que me habían servido durante años como base para distintos trabajos de consultoría), archivos incompletos y documentos que reflejaban diferentes etapas de la infraestructura. A veces, dos documentos parecían contradecirse simplemente porque pertenecían a meses distintos.
En un momento dado recordé que todavía conservaba una copia de seguridad en cinta de mi estación de trabajo. La cinta DAT había sobrevivido casi treinta años dentro de una caja en el sótano. La copia original se había grabado con un lector DAT de Sun conectado por SCSI a DVLP, un equipo con SunOS. Para intentar recuperarla, en cambio, alquilé un lector DAT USB
Del módem a la fibra: cambian las tecnologías, pero las preguntas siguen siendo las mismas
Antes de entrar en los detalles de Internet Force, merece la pena detenerse un momento en una diferencia fundamental entre aquella época y la actual.
En 1995, conectarse a Internet era algo que había que hacer de forma explícita: el ordenador llamaba por teléfono al proveedor, los dos módems negociaban la conexión y solo entonces empezaba la sesión de red.
Hoy, con una conexión fija, damos por hecho que Internet está siempre ahí. Sin embargo, detrás de esta enorme diferencia, los proveedores siguen teniendo que resolver problemas sorprendentemente parecidos. A continuación, repasamos las principales diferencias.
En pocas palabras:
- ISP de mediados de los 90: conexión punto a punto a través de la línea telefónica: módem, servidor de acceso (terminal server/access server), autenticación contra una base de datos centralizada y, después, conexión IP.
- ISP con FTTH actual: conexión punto a multipunto a través de fibra óptica: ONT, red PON con divisores pasivos (splitters), OLT, BNG, AAA/RADIUS, backbone y conexiones de peering o tránsito.
Comparativa detallada
| Aspecto | Conexión telefónica de los años 90 (Dial-up) | Fibra óptica hasta el hogar (FTTH) actual |
|---|---|---|
| Medio físico | Línea telefónica, módem de 28,8 kbit/s y llamada telefónica | Fibra óptica y ONT (Optical Network Terminal, terminal de red óptica) en casa |
| Concentración | Grupo de módems (modem pool) → servidor de acceso | Divisores ópticos pasivos (splitters) → OLT (Optical Line Terminal, terminal de línea óptica) |
| Sesión y autenticación | El servidor de acceso consulta una base de datos central de usuarios | BNG (Broadband Network Gateway, puerta de enlace de banda ancha) + AAA/RADIUS: identifica al usuario, autoriza el acceso y registra la actividad |
| Dirección IP | Se asigna después de identificar al abonado | El BNG gestiona la conectividad IP y los perfiles de servicio |
| Salida a Internet | Router del proveedor → Internet | Red troncal (backbone) → acuerdos de interconexión (peering) / IXP o tránsito IP |
| Filosofía | Conexión punto a punto (point-to-point) y equipos de distintos fabricantes | PON (Passive Optical Network, red óptica pasiva), con control centralizado mediante software y políticas de red |
La diferencia fundamental es que antes el cuello de botella estaba en el módem y la línea telefónica. Hoy, la parte óptica es pasiva y compartida, mientras que la inteligencia y el control se concentran en los equipos OLT, BNG y AAA.
Otra diferencia evidente es que ya no tenemos que «llamar» a Internet. La conexión es permanente, compartida y funciona mediante conmutación de paquetes desde la propia red de acceso.
Pero la idea general sigue siendo la misma: acceso → identificación del abonado → asignación de conectividad IP → agregación → backbone → Internet.
Y es precisamente esta continuidad en el funcionamiento, oculta bajo tecnologías completamente diferentes, lo que hace tan interesante esta arqueología de un ISP.
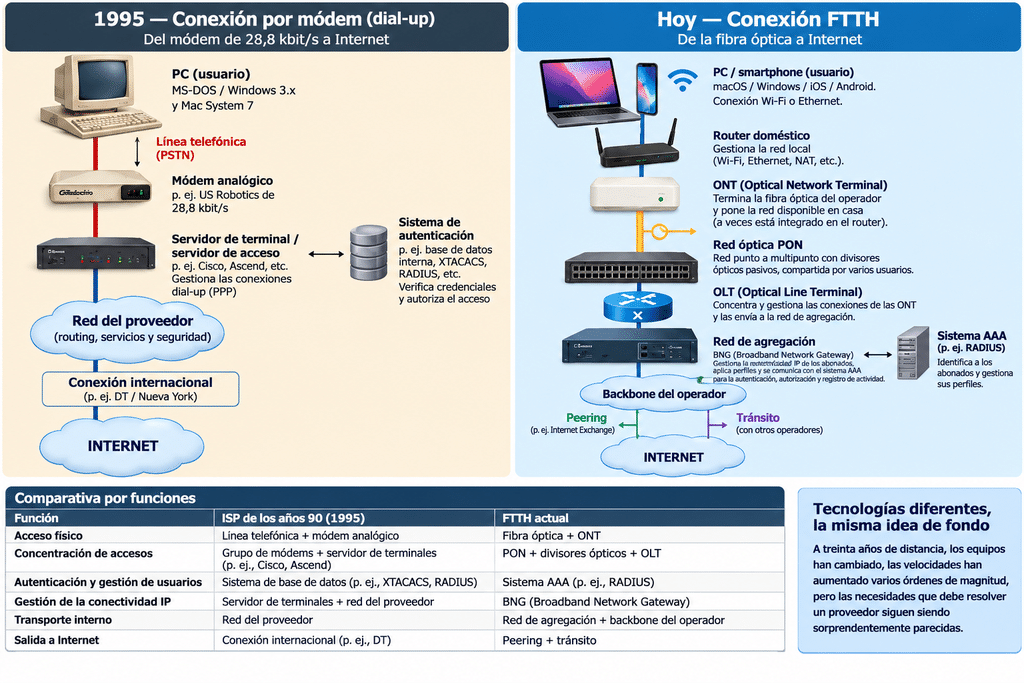
Figura 1 — Dos formas de conectarse a Internet: conexión por módem en 1995 y una arquitectura FTTH actual. Los equipos han cambiado, pero las funciones básicas siguen siendo reconocibles.
Una Internet mucho más pequeña
Para entenderlo bien, primero tenemos que situarnos en 1995. En 1994, la ITU (Unión Internacional de Telecomunicaciones) estimaba que había unos 20 millones de usuarios de Internet en todo el mundo, apenas el 0,3 % de la población.
Amazon abriría su librería online en julio de 1995. En octubre de ese mismo año ya anunciaba que recibía pedidos de 45 países.
Precisamente en otoño de 1995 (¡he encontrado un recibo que lo demuestra!), yo también hacía pedidos a Amazon de manuales y libros de informática en inglés que eran difíciles de encontrar en Italia. Me los enviaban directamente a la oficina. La documentación sobre cómo funcionaban los servicios de Internet era tan reciente y evolucionaba tan rápido que solo se podía encontrar online.
Internet ya existía como negocio y la Web empezaba a crecer a toda velocidad, pero para la mayoría de la gente en Italia conectarse significaba convertir una línea telefónica en una conexión de datos durante unas horas, dejando muchas veces al resto de la familia sin teléfono.
Usenet: aprender y devolver algo a la red
Otra gran escuela era Usenet. En sus grupos de noticias técnicos podías encontrarte con gente que sabía muchísimo y pedir ayuda, pero las normas de convivencia estaban bastante claras: primero había que buscar las FAQ, leer la documentación e intentar entender el problema. Después, tocaba hacer la pregunta explicando el sistema, la versión, la configuración, el mensaje de error y las pruebas que ya habías realizado.
De aquella cultura también nació el famoso RTFM, Read The Fucking Manual («léete el puñetero manual»). Hoy puede sonar poco diplomático, pero entonces se entendía perfectamente en su contexto. No significaba simplemente «búscate la vida», sino que, antes de pedir ayuda, se esperaba que al menos hubieras intentado leer el manual, las FAQ y la documentación disponible. La comunidad compartía muchísimos conocimientos, pero a cambio pedía un mínimo de trabajo previo.
Eso de dar por hecho que todo el mundo está a tu disposición todavía no se consideraba una conquista de la humanidad.
Usenet no era una página web ni pertenecía a ninguna plataforma. Era un sistema distribuido de grupos de discusión organizados por temas: los mensajes publicados en un grupo de noticias se distribuían entre los servidores que formaban parte de la red.
Para quienes trabajábamos con Unix e Internet, era al mismo tiempo un lugar donde debatir, recibir ayuda técnica, consultar experiencias de otros y conocer a personas que estaban resolviendo los mismos problemas al otro lado del mundo.
Usenet sigue existiendo técnicamente, pero aquel papel central que tuvo en la cultura de Internet prácticamente ha desaparecido.
También había un principio de reciprocidad que hoy me parece importante recordar. En mi trabajo aprendía constantemente gracias a la documentación, las FAQ, las listas de correo, el código fuente y los debates que otras personas compartían. Así que, cuando podía, intentaba devolverle a la red una parte de todo ese conocimiento.
En aquellos años me convertí en autor de las FAQ de it.comp.linux y publiqué en it.faq documentos sobre emoticonos, el ciberespacio y la jerga hacker, además de otros materiales técnicos y culturales.
He recuperado varios de aquellos mensajes originales, con las cabeceras completas con las que circulaban por Usenet, y los he guardado en el repositorio junto con el resto de documentos.
Por eso he decidido incluir en el repositorio, además de las configuraciones de los equipos, una pequeña sección dedicada a Usenet. En ella he reunido los documentos que publicaba entonces, conservando sus fechas originales. También he seleccionado algunos mensajes de correo para guardar pequeños fragmentos del día a día de aquella Internet.
Más adelante volveré sobre estos materiales y sobre otras cosas que han aparecido en las mismas copias de seguridad, porque cuentan aspectos de la cultura técnica de aquella época que no se pueden descubrir consultando únicamente las configuraciones.
Los mensajes de otras personas solo se publican cuando es apropiado y, cuando hace falta, se han anonimizado. La arqueología digital no pretende despertar contactos míos que llevan más de treinta años durmiendo.
Cómo convertirse en administrador de sistemas sin ser todavía administrador de sistemas
Hay una historia previa que merece la pena contar, sobre todo para evitar que se malinterprete lo que viene después.
Cuando los socios de Internet Force publicaron una oferta para buscar al administrador de sistemas del proveedor que estaban poniendo en marcha, yo ya llevaba unos cuantos años haciendo trabajos de consultoría informática. Montaba PC cuando hacía falta, programaba por mi cuenta y había trabajado en un centro de procesamiento de datos de la Marina, donde había aprendido bastante.
También había empezado a crear páginas web en HTML para pequeños proveedores de Internet de Milán y colaboraba con algunas revistas de informática escribiendo artículos técnicos.
Sin embargo, mi experiencia con Unix se limitaba a haberlo utilizado como usuario durante la universidad.
Aun así, me presenté al puesto. Por las noches estudiaba manuales y aprendí suficiente Unix para superar la entrevista. Conseguí convencer a los socios, que técnicamente sabían menos que yo. Dicho de una forma menos elegante: se me dio bastante bien aparentar que sabía más de lo que realmente sabía.
El problema llegó cuando entraron en escena los consultores israelíes de Xpert UNIX Systems, a quienes se había encargado el diseño técnico del ISP. Les bastaron unos pocos días para darse cuenta de cuál era realmente mi nivel.
Meses después me dijeron que, aun así, habían valorado mucho mi determinación y la rapidez con la que aprendía. Por eso decidieron formarme.
En particular, me asignaron al mítico Yahel Ben-David, que vino expresamente desde Israel y acabó convirtiéndose, en la práctica, en mi tutor.
Su método no consistía en darme configuraciones ya preparadas para que las copiara. Me implicaba en el diseño, me preguntaba qué solución habría elegido y por qué. Cuando me equivocaba, muchas veces me dejaba avanzar lo suficiente para que entendiera dónde estaba el problema y después me hacía repetir todo el proceso.
Era prácticamente un método socrático: pasábamos juntos todo el día, desde las ocho de la mañana hasta las once de la noche, para que llegara a la fecha de lanzamiento bien preparado y capaz de gestionar el proveedor. No hace falta decir que pronto nos hicimos amigos.
Fueron ellos quienes también me descubrieron Linux y convencieron a los socios para que me proporcionaran una estación de trabajo 486DX bastante potente, con 16 MB de RAM, una controladora Adaptec AHA2940 y discos SCSI (algo poco habitual en los PC de aquella época), para que pudiera hacer mis propias pruebas y experimentos.
Mientras en Italia esperábamos la llegada de un equipo Sun que faltaba y la activación de la conexión internacional, pasé unos seis meses en Tel Aviv continuando mi formación directamente allí, junto a quienes estaban diseñando la infraestructura.
Así que, cuando Internet Force empezó a funcionar en 1995, no me limitaba a administrar una red diseñada por otras personas: había participado en su construcción desde el principio, aprendiendo a entender las decisiones técnicas y a reconstruirla desde cero si alguna vez hacía falta.
Un ISP pensado como una red, no como una BBS con más funciones
En 1995, la palabra proveedor podía referirse a empresas con infraestructuras técnicas muy diferentes.
Muchos pequeños operadores italianos venían directamente del mundo de las BBS y de FidoNet. Los conocí bien también en los años siguientes, cuando trabajé como consultor en la transformación de varios proveedores de Internet de Milán.
Sus infraestructuras solían partir de PC convencionales, grupos de módems que iban ampliando poco a poco, cableado y servicios que crecían alrededor de uno o dos ordenadores y, cuando había suerte, una conexión permanente de 64 kbit/s con un operador nacional.
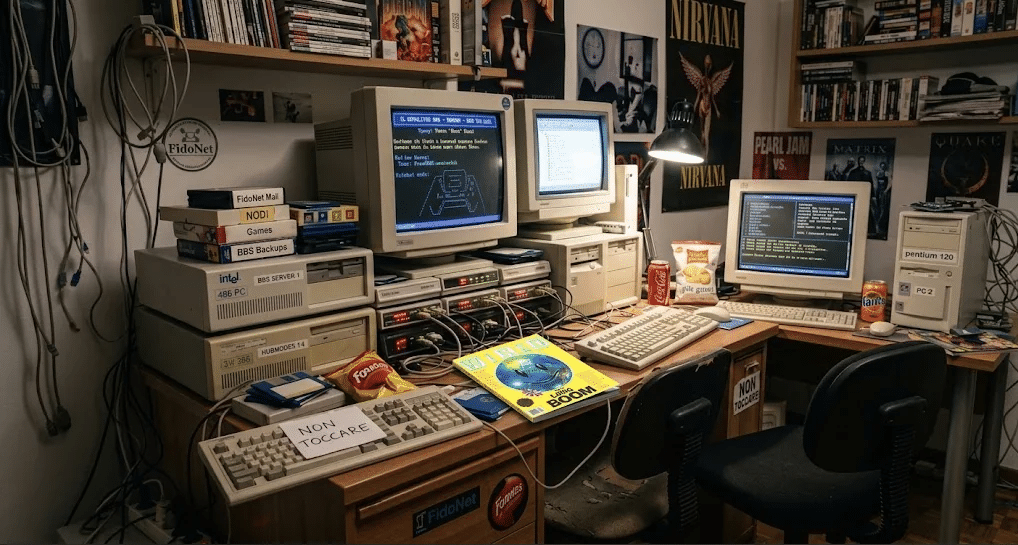
Reconstrucción de un pequeño proveedor de Internet/BBS italiano de la época, antes de una intervención de reorganización de la infraestructura que realicé en 1997.
Internet Force se había planteado de otra manera desde el principio. Los socios contactaron con la empresa estadounidense IDT, que les puso en contacto con Xpert UNIX Systems. El modelo seguía una línea similar a la de los proveedores de Internet estadounidenses de aquella época: sistemas Unix dedicados, routers y servidores de acceso Cisco, POP distribuidos, autenticación centralizada, funciones separadas entre los distintos equipos y la seguridad integrada en el propio diseño de la infraestructura.
La conexión internacional empezó con 128 kbit/s y, unos seis meses después, se amplió a 2 Mbit/s para conectar con IDT en Estados Unidos.
La infraestructura también había alcanzado ya un tamaño considerable. Durante la fase de expansión de 1996, teniendo en cuenta los nuevos POP, el aumento de las líneas en Milán y la proporción entre abonados y módems utilizada para dimensionar el servicio, Internet Force llegó a tener unos 2.000 abonados.
En un proveedor de acceso telefónico (dial-up), lo importante no era solo cuántos clientes tenías, sino cuántos podían conectarse al mismo tiempo. Ofrecer acceso a miles de personas implicaba calcular cuántos módems, líneas telefónicas y conexiones entre distintas ubicaciones necesitabas, teniendo en cuenta que solo una parte de los abonados estaría conectada simultáneamente.
Para entender mejor esa cifra, basta con mirar cómo se dimensionaban las líneas. Como regla general, se calculaban entre 8 y 16 abonados por módem. Así, cada grupo de 16 módems podía dar servicio a entre 128 y 256 clientes. Sumando los nuevos POP de 1996 y la ampliación de las líneas en Milán, era posible atender a varios miles de abonados sin necesidad de tener miles de módems.
Para hacerse una idea de la escala, en 1995 Video On Line, por entonces el mayor proveedor de Internet de Italia, tenía unos 15.000 abonados, lo que representaba aproximadamente el 30 % del mercado italiano. Internet Force seguía siendo un operador mucho más pequeño, pero alcanzar los 2.000 abonados ya suponía un tamaño considerable, muy lejos de cualquier proyecto amateur.
Hoy, dos megabits son menos de lo que una página web moderna puede llegar a consumir antes incluso de mostrar su título. Pero para un pequeño proveedor de Internet italiano de 1995, eran una capacidad bastante importante.
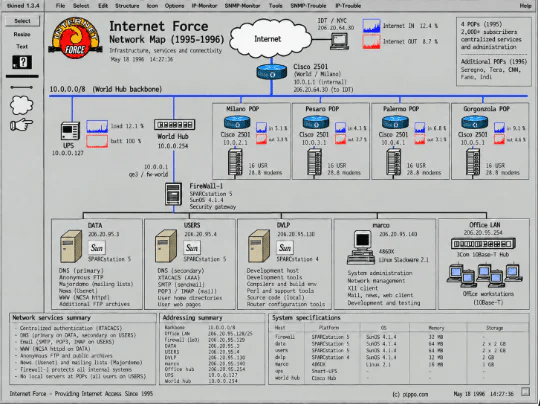
Mapa de la red de Internet Force: vista general de la infraestructura, reconstruida a partir del mapa original de tkined y de los documentos conservados.
Internet se construía pieza a pieza
Hay un aspecto de Internet en aquella época que hoy puede pasar desapercibido: la red no solo tenía protocolos abiertos. Las especificaciones se publicaban en las RFC y una parte importante del software necesario para crear los servicios de Internet estaba disponible en código fuente. Se podía compilar en distintas plataformas Unix y lo desarrollaban universidades, grupos de investigación y comunidades repartidas por todo el mundo.
BIND se encargaba del DNS; Sendmail gestionaba el protocolo SMTP; distintos servicios ofrecían FTP, POP e IMAP; y otros programas se ocupaban de Usenet, las listas de correo y el IRC. En el mundo web, en 1996, NCSA HTTPd daría paso al recién creado proyecto Apache.
No todo el software que utilizábamos encajaría automáticamente en la definición actual de «código abierto» (open source), un término que no aparecería hasta 1998. Pero la cultura técnica de entonces se basaba en estándares públicos, interoperabilidad y acceso al código fuente. Esto permitía entender cómo funcionaban los componentes, adaptarlos e integrarlos.
Por eso, para administrar un ISP no necesitabas comprar necesariamente un paquete que te proporcionara «Internet». Internet se construía pieza a pieza. Se partía de protocolos definidos públicamente y de programas cuyo código fuente estaba disponible. Después había que compilarlos en la plataforma Unix elegida, configurarlos y conseguir que todos funcionaran juntos.
Eso es exactamente lo que hicimos en Internet Force. DNS, correo electrónico, Web, autenticación, FTP, News y listas de correo eran servicios independientes, construidos con distintos programas que el administrador de sistemas tenía que conocer lo suficiente como para integrarlos.
Por eso, treinta años después, me parece tan coherente publicar las configuraciones en el repositorio. Forma parte de la misma cultura con la que nació aquella red: la mejor manera de entender un sistema es poder examinar cómo está construido.
Unix en el centro de todo
El núcleo del ISP estaba formado por equipos Sun con SunOS. La decisión de utilizar SunOS en lugar de Solaris, que era más reciente, respondía a la valoración de los consultores de Xpert: para una infraestructura que iba a estar expuesta a Internet, preferían en aquel momento una plataforma que consideraban más madura y que conocían mejor.
Cada máquina tenía una función específica. DATA alojaba la web pública, el DNS primario, el FTP anónimo, las listas de correo y, en distintas etapas, algunos servicios relacionados con Usenet.
USERS concentraba las cuentas y los servicios de los usuarios: autenticación XTACACS, correo electrónico, directorios personales (home directories), POP3 e IMAP, además del DNS secundario.
DVLP era el equipo dedicado al desarrollo y la compilación de software. Mi estación de trabajo Linux, llamada «marco», era desde donde administraba y supervisaba toda la infraestructura.
Los nombres de los equipos también contaban algo sobre la empresa, aunque no precisamente lo que a mí me habría gustado.
En el mundo Unix era bastante habitual elegir nombres de equipos pertenecientes a un mismo universo: personajes mitológicos, astronomía, literatura o ciencia ficción. Mi primera propuesta fue El Señor de los Anillos; como segunda opción tenía el Olimpo griego y, en tercer lugar, Star Wars.
A los socios de Internet Force les pareció una idea demasiado informal para una empresa y optaron por nombres bastante más sobrios: los servidores recibieron nombres relacionados con su función, como «data», «users» y «dvlp», mientras que las estaciones de trabajo se bautizaron según las personas que las utilizaban.
Treinta años después, como hacker en el sentido original del Tech Model Railroad Club del MIT, quiero dejar constancia oficial de mi desacuerdo. Teníamos la oportunidad de llamar a un servidor «gandalf» y elegimos «users».
Una pequeña revancha llegó al año siguiente. Cuando instalé el sistema Windows NT destinado a los experimentos con Oracle, le asigné personalmente el nombre de host «oracolo» (oráculo). Esta vez, por prudencia, no convoqué ningún comité para decidir el nombre.
La filosofía básica para los sistemas expuestos públicamente era reducir al mínimo todo lo que había instalado en los equipos de producción. Los compiladores, las herramientas de desarrollo y el software que no era necesario para la función del servidor se quedaban exclusivamente en DVLP.
Los servidores accesibles desde Internet se instalaban y protegían (hardening), dejando únicamente lo imprescindible para su funcionamiento. El software se compilaba en DVLP y después se transferían los ejecutables a los equipos de producción.
En 1995 también utilizábamos FTP interno para realizar estas transferencias. Poco después, nuestra forma de trabajar evolucionó con la incorporación de herramientas más seguras, como SSH y SCP.
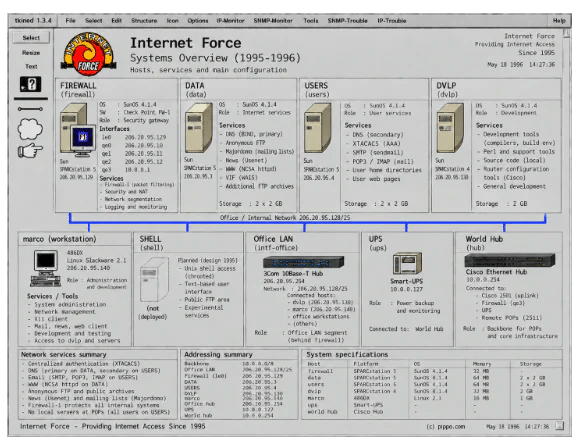
Vista general de los sistemas: DATA, USERS, DVLP, firewall, estación de trabajo de administración y red local de la oficina (Office LAN).
La seguridad como parte de la arquitectura
Otra decisión importante fue utilizar Check Point FireWall-1, instalado en un Sun SPARCstation 5 con SunOS 4.1.4.
FireWall-1 acababa de salir al mercado y ofrecía una idea bastante avanzada para aquella época: la Stateful Inspection (inspección con estado), junto con una interfaz gráfica X11 que permitía definir las políticas de seguridad mediante objetos que representaban equipos, redes y servicios.
Lo interesante no era simplemente tener un firewall, sino cómo estaba integrado en la red. DATA y USERS tenían conexiones Ethernet independientes al firewall, y la red de la oficina (Office LAN) constituía otro segmento separado.
No era una única red local en la que se colocaba un filtro delante de todo. Las políticas definían expresamente qué equipos podían acceder a cada sistema y mediante qué protocolos.
Entre los materiales recuperados también hay un GIF original con las reglas de FireWall-1. Es uno de mis documentos favoritos porque no solo demuestra que teníamos un firewall, sino que permite entender cómo funcionaba realmente la red.
La regla 7, ts → users, tacacs, corresponde a la parte de autenticación: los servidores de terminales podían consultar USERS sin que el tráfico de Internet de los abonados tuviera que pasar por ese servidor.
La regla 12, news.ios.com → data, nntp, muestra el feed de Usenet que llegaba desde el exterior.
La regla 13 autorizaba el acceso desde xpert.com a DVLP y a mi estación de trabajo «marco» mediante talk y deslogin. Era la forma de permitir el acceso remoto al proveedor israelí, utilizando un mecanismo de inicio de sesión cifrado, antes de que SSH se convirtiera en la herramienta habitual para hacer este tipo de conexiones.
En una sola pantalla aparecen, por tanto, la autenticación centralizada, la recepción de mensajes de Usenet y el acceso remoto de un proveedor externo. Problemas que hoy llamaríamos gestión de identidades (identity), exposición de servicios (service exposure) y acceso de terceros (third-party access).
Y al final de las políticas estaba la regla que daba sentido a todas las demás:
Any → Any → Any: STOP
Es decir, todo lo que necesitaba pasar tenía que estar autorizado expresamente. El resto se bloqueaba.
Hay, sin embargo, una distinción importante: los clientes que se conectaban por módem no estaban «detrás» de FireWall-1.
El firewall protegía los servidores centrales y la red de la oficina. El tráfico habitual de los clientes hacia Internet circulaba por el lado externo de la red (world). Solo atravesaba el firewall cuando necesitaba acceder a algún servicio protegido, como la autenticación en USERS o los servicios centrales permitidos por las políticas de seguridad.
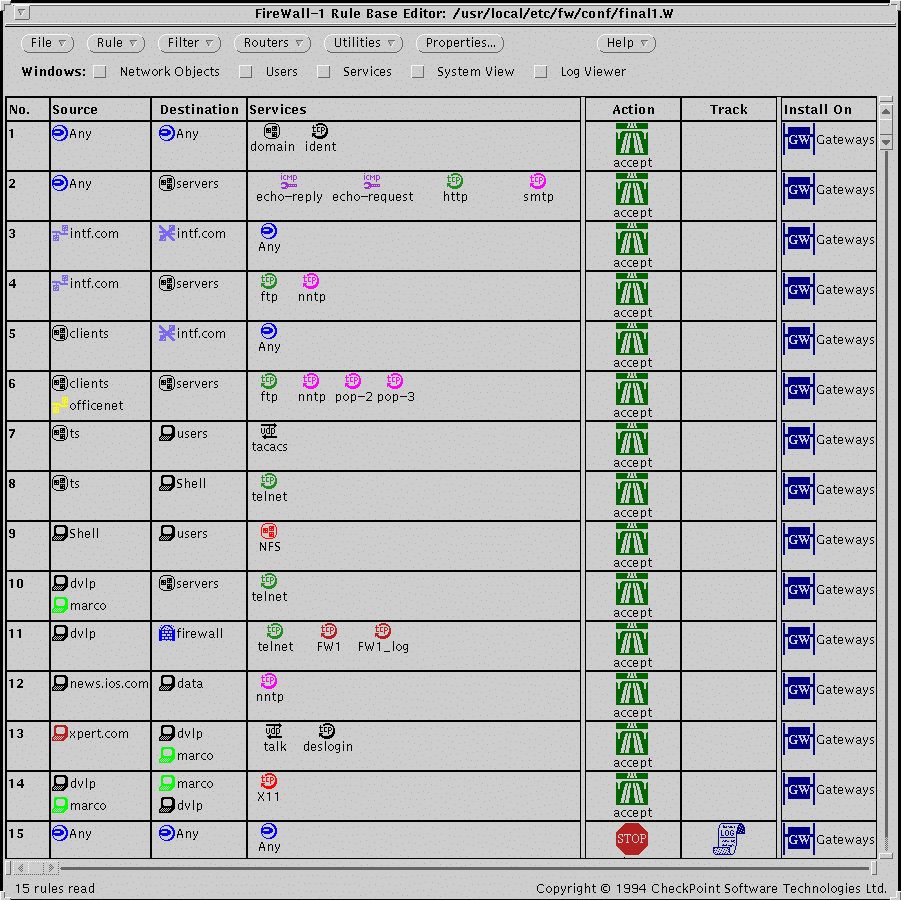
Captura de pantalla original de las reglas de Check Point FireWall-1 en X11, 1995.
Seguir una conexión: de Milán a Internet
La forma más sencilla de explicar el resto de la arquitectura es seguir el recorrido de un usuario. En 1995 no abrías una aplicación para conectarte: hacías una llamada telefónica.
Pero antes de poder llamar, el cliente tenía que estar dado de alta. El departamento comercial dejaba en secretaría un formulario en papel con los datos del cliente y el contrato firmado. Desde el ordenador llamado «anna», esos datos se introducían en el programa de gestión y después me los enviaban por correo electrónico para que creara la cuenta en los sistemas del proveedor y activara su acceso.
Desde ese mismo ordenador también llegaban por correo electrónico las solicitudes de asistencia técnica. Los problemas más habituales se resolvían consultando las FAQ que había preparado, mientras que las cuestiones más técnicas me las remitían directamente.
Entre los documentos recuperados también se conservan algunos de aquellos intercambios de correos. Gracias a ellos he podido reconstruir cómo era el trabajo diario entre los departamentos comercial, administración, atención al cliente e infraestructura técnica.
El cliente de Milán marcaba el número de acceso. La red telefónica utilizaba un sistema de búsqueda para desviar la llamada a una línea libre, conectada a uno de los módems. Al principio, el POP tenía dieciséis módems: dieciséis líneas permitían dieciséis conexiones simultáneas, porque cada sesión ocupaba físicamente un módem y una línea telefónica durante todo el tiempo que duraba la conexión.
El módem negociaba la conexión con el del cliente y entregaba la línea serie a un Cisco 2511. En este equipo, las interfaces asíncronas estaban configuradas para utilizar PPP. El servidor de acceso recibía el nombre de usuario y la contraseña, pero no almacenaba la base de datos de usuarios.
La autenticación era el primer paso
El Cisco 2511 consultaba al servidor USERS mediante XTACACS. Es importante entender bien este proceso: USERS no estaba «en medio» del tráfico de Internet del cliente. El 2511 preguntaba a USERS si las credenciales eran válidas y, una vez recibida la respuesta, la sesión PPP podía continuar a través de la red.
Así, un único sistema de autenticación daba servicio a todos los POP.
En muchos PC con Windows, el acceso TCP/IP todavía requería instalar software específico. Entre los materiales conservados está, por ejemplo, la distribución de Trumpet Winsock 3.0, junto con las instrucciones de configuración que proporcionábamos a los usuarios.
También he recuperado íntegramente el Welcome Kit de Internet Force (y he decidido publicar incluso los archivos fuente). Lo había preparado para los clientes del proveedor e incluía programas, entre ellos las versiones de Netscape y Eudora de aquella época, además de instrucciones para configurar la conexión y empezar a navegar.
Es un documento especialmente interesante porque muestra el otro extremo de la infraestructura: por un lado, Cisco, Sun, DNS y autenticación; por otro, un usuario con Windows, un módem y ninguna necesidad de saber qué era PPP.
Después llegaban el DNS y el routing
Una vez autenticado, el cliente ya estaba conectado a la red. Si abría Netscape y escribía la dirección de una página web, antes incluso de descargarla, el resolver tenía que consultar al DNS para obtener la dirección IP correspondiente.
Internet Force gestionaba directamente sus propios servidores de nombres (name servers), primario y secundario, alojados en los sistemas centrales.
Una vez obtenida la dirección IP, los paquetes del cliente de Milán pasaban del 2511 a la red troncal «world» y llegaban al Cisco 2501 central. Este router dirigía el tráfico a través de la conexión Frame Relay hacia IDT y, desde allí, a Internet.
El firewall no formaba parte del recorrido habitual de esa conexión.
La dirección IP de la sesión también se asignaba dinámicamente: el rango de direcciones disponibles (pool) lo gestionaba el servicio DHCP proporcionado por los propios servidores de acceso.
El routing de la red, en cambio, se mantuvo estático. El diseño que habíamos hablado con Xpert contemplaba introducir IGRP cuando el crecimiento de la infraestructura lo hiciera necesario. Además, con la incorporación de una segunda conexión a un operador italiano, Internet Force habría tenido que evolucionar hacia su propio Sistema Autónomo (Autonomous System).
La empresa cerró antes de que ese cambio llegara a ser necesario.
La misma llamada desde Pésaro, Palermo o Gorgonzola
Los POP remotos añadían un paso más al recorrido, pero no duplicaban los servicios centrales.
Pésaro, Palermo y Gorgonzola tenían cada uno una pareja de equipos Cisco: un 2511 para las líneas asíncronas y las conexiones por módem, y un 2501 que conectaba el POP con la red troncal del proveedor.
Los dos routers estaban conectados entre sí localmente. Desde allí, el POP llegaba hasta Milán mediante un circuito dedicado CDA/CDN de 64 kbit/s.
Por ejemplo, un cliente de Pésaro seguía un recorrido bastante sencillo:
Teléfono → módem → Cisco 2511 → Cisco 2501 del POP → red troncal → Cisco 2501 central → IDT → Internet.
Cuando necesitaba autenticarse, el 2511 abría una conexión XTACACS con USERS, situado en Milán.
Esta arquitectura permitía mantener los POP relativamente sencillos. No hacía falta administrar servidores de usuarios, servidores de correo o servidores DNS completos en cada ciudad: los puntos de acceso se encargaban de recibir las conexiones, mientras que las cuentas de usuario y los servicios permanecían centralizados.
Xpert también me enseñó una regla práctica para dimensionar este tipo de redes. El número mágico era el 8, no el 42.
Para calcular el ancho de banda, multiplicábamos por ocho la capacidad de la conexión geográfica y comparábamos el resultado con el ancho de banda nominal total de los módems.
En un POP con 16 módems de 28,8 kbit/s, la carga teórica máxima era de unos 461 kbit/s. Por otro lado, una conexión CDN de 64 kbit/s multiplicada por ocho daba 512 kbit/s.
Mientras este segundo valor fuera superior al primero, considerábamos que la capacidad estaba bien dimensionada.
Naturalmente, era una regla estadística: se daba por hecho que no todos los usuarios estarían transfiriendo datos al mismo tiempo y a la máxima velocidad.
Se aplicaba una lógica parecida al número de líneas. Los técnicos de Xpert me recomendaban como referencia para un proveedor de calidad entre 8 y 16 abonados por módem. Era una proporción que permitía mantener una probabilidad razonable de encontrar una línea libre, incluso en las horas de mayor demanda.
Así, un POP con 16 módems podía dar servicio aproximadamente a entre 128 y 256 abonados, sin necesidad de tener una línea telefónica dedicada para cada uno.
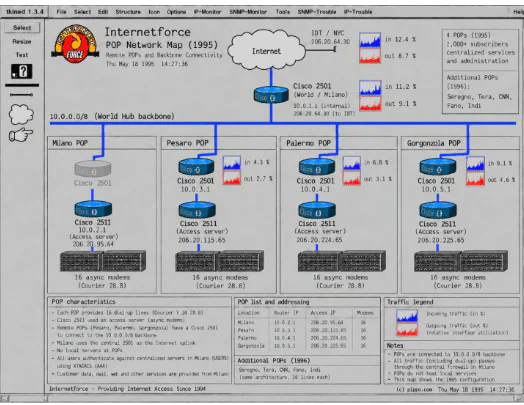
Detalle de los POP: Milán y los tres POP remotos iniciales, junto con la ampliación posterior de 1996.
Estar conectado significaba utilizar los servicios del proveedor
Conectarse a Internet era solo una parte de la experiencia. Un proveedor de Internet (ISP) tenía que ofrecer y administrar directamente una gran variedad de servicios que hoy damos por sentados o dejamos en manos de plataformas externas.
Correo electrónico
Los correos llegaban mediante SMTP y se almacenaban en los sistemas del proveedor. El programa de correo del usuario los recuperaba a través de POP3 o IMAP. Por tanto, USERS no solo alojaba la identidad necesaria para conectarse, sino también una parte importante de la vida digital cotidiana de cada abonado.
Web, FTP, News y listas de correo
DATA alojaba la web pública y el servicio FTP anónimo, además de otros servicios y contenidos que fueron cambiando con el tiempo. Las listas de correo se gestionaban con Majordomo. Usenet todavía formaba parte de la experiencia habitual de Internet. El flujo de noticias externo llegaba desde news.ios.com mediante NNTP: es el mismo tráfico que aparece en la regla 12 de la política de FireWall-1.
Esta es quizá una de las diferencias más evidentes respecto a muchos servicios de Internet actuales: el proveedor no se limitaba a ofrecer una conexión. Tenía que construir y mantener todo un pequeño ecosistema de servicios interoperables.
Para el usuario eran iconos independientes en el escritorio: Netscape, Eudora, un cliente FTP, un lector de noticias o Telnet. Detrás de cada icono había un protocolo y, detrás de ese protocolo, un daemon que alguien tenía que configurar y mantener en funcionamiento.
Detrás de la red había una oficina
Las configuraciones cuentan bastante bien cómo estaban organizados los equipos, pero dicen menos sobre las personas. Sin embargo, la LAN de la oficina también ha dejado una especie de organigrama fósil: los nombres de los ordenadores.
Algunos eran funcionales, como «dvlp» y «html»; otros coincidían con los nombres que utilizábamos en la oficina para identificar las estaciones de trabajo. Volver a verlos hoy probablemente sea la forma más rápida de que un antiguo compañero reconozca su puesto de trabajo, sin necesidad de convertir este artículo en la guía telefónica de 1995.
El entorno era muy heterogéneo. Mi estación de trabajo, «marco», era un 486DX con Linux Slackware; DVLP era una Sun SPARCstation; «maxi», que utilizaba uno de los comerciales, era un PowerBook; y varios ordenadores de la oficina eran Macintosh con System 7.5.x.
«Laura» y «Alice», en concreto, eran Power Macintosh 9500 de la redacción. En 1996 apareció también «oracolo», un sistema Windows NT con Oracle. Todos estos equipos convivían en la misma infraestructura Ethernet de la oficina, conectados mediante un hub de 3Com.
La redacción: web y papel
Internet Force tenía una redacción periodística que producía contenidos tanto para la web como para una revista en papel.
Laura y Alice eran estaciones de trabajo Power Macintosh 9500 equipadas con un conjunto completo de herramientas de maquetación y edición de imágenes: QuarkXPress, Adobe PageMaker, Adobe Photoshop y Adobe Type Manager.
La dirección artística trabajaba, en cambio, desde el equipo «salvatore», donde también preparaba las imágenes finales destinadas a las webs.
El ordenador «HTML» tenía una función mucho menos ambigua de lo que su nombre podía sugerir: allí se escribían las páginas directamente en HTML. En 1995, si querías comprobar de verdad el resultado, era una práctica de lo más habitual.
Del archivo HTML al servidor público
El paso de la redacción a producción ya estaba separado. Había preparado en DVLP un espacio FTP de uso interno. Salvatore proporcionaba los recursos gráficos a HTML; desde allí se construían las páginas y, cuando la web estaba terminada, todos los archivos se depositaban en una carpeta específica para los sitios web dentro del FTP interno.
A partir de ahí intervenía yo. Descargaba el sitio, comprobaba que estuviera completo y funcionara como debía y lo subía a DATA.
Por tanto, la redacción no publicaba directamente en el servidor web de producción. Había una fase de creación, un espacio de intercambio que hoy llamaríamos staging, una comprobación técnica y, por último, el despliegue. Entonces no lo llamábamos CI/CD, y quizá mejor así: funcionaba sin necesidad de un panel con doce indicadores verdes.
Cuando necesitaba incorporar funcionalidades interactivas, desarrollaba personalmente los CGI. En marzo de 1996 instalé PHP/FI (una de las primeras versiones de PHP, que se compilaba como CGI). Más adelante llegó también Postgres95 a DATA, la base de datos que con el tiempo pasaría a conocerse como PostgreSQL.
Todavía no recuerdo la fecha exacta de instalación de la base de datos. Y la arqueología también sirve para esto: dejar una fecha pendiente hasta que aparezca la pieza que permita confirmarla.
En apenas unos meses, esta forma de trabajar refleja una transformación mucho más amplia de la web: páginas estáticas escritas a mano, CGI, scripting del lado del servidor y, finalmente, datos persistentes gestionados mediante una base de datos.
Un servidor Oracle porque el trabajo cambiaba constantemente
«Oracolo», documentado en el archivo de 1996, era un experimento con Windows NT y Oracle. No formaba parte del núcleo Unix del proveedor: los socios querían adquirir experiencia con esa plataforma para poder ofrecer también servicios de consultoría a sus clientes.
El detalle curioso es que yo no tenía conocimientos de Oracle ni de Windows NT.
Los estudié por mi cuenta en unos siete o diez días y llevé a cabo el proyecto. Es un episodio que describe bastante bien lo que significaba ser el responsable técnico de una pequeña empresa de Internet en aquella época: no había un equipo de Unix, otro de bases de datos, otro de seguridad, otro de redes y otro de desarrollo web. Las responsabilidades cambiaban según el problema que hubiera que resolver.
Una red que podías ver
Todo el sistema se monitorizaba desde mi estación de trabajo Linux mediante Scotty/Tkined, un entorno Tcl/Tk para la gestión de redes.
El mapa no era simplemente un dibujo: mediante SNMP podía consultar el tráfico de las interfaces, el uso de las líneas asíncronas de los Cisco, el estado de los nodos y otros indicadores operativos.
Precisamente, una de las piezas que ha permitido reconstruir buena parte de la historia en 2026 ha sido un mapa original de Tkined que se conservaba en las copias de seguridad.
Al compararlo con las configuraciones de Cisco, los archivos de routing, DNS, la documentación del hardware y las políticas del firewall, ha sido posible distinguir qué recordaba correctamente, qué correspondía a momentos diferentes y qué detalles se habían mezclado inevitablemente durante estos treinta años.
Vista desde hoy, la infraestructura parece diminuta: unos cuantos equipos Sun, varios Cisco, racks de módems, dos hubs Ethernet y una conexión internacional que primero tenía una capacidad de 128 kilobits y después pasó a los dos megabits.
Pero en aquel mapa ya estaban presentes prácticamente todos los problemas fundamentales de un proveedor de Internet: acceso, routing, AAA, DNS, correo electrónico, web, seguridad, monitorización, aprovisionamiento y publicación de contenidos.
El repositorio: la capa que hay debajo de la historia
Este artículo se centra deliberadamente en los procesos, no en los archivos. El repositorio de GitHub hace justo lo contrario: permite abrir el capó y explorar cómo estaba construida la infraestructura.
Las configuraciones de Cisco y Unix, las zonas DNS, las políticas del firewall, los mapas de red, los documentos operativos y los materiales recuperados están organizados para que puedan consultarse en su contexto, diferenciando los documentos originales de las reconstrucciones.
Sin embargo, he intentado que no se convierta en una simple colección de archivos antiguos. Los mapas interactivos permiten explorar los POP, la red central y los distintos sistemas, pasando de las máquinas a las configuraciones que han sobrevivido.
Quien prefiera seguir un recorrido más técnico puede empezar por «Build an Internet Force POP», una guía que intenta responder a una pregunta muy concreta: si en 1995 hubieras tenido que montar un proveedor de Internet, ¿por dónde habrías empezado?
El recorrido comienza con la preparación de una máquina Unix y continúa por el routing, los módems y servidores de acceso, la autenticación, el DNS, el correo electrónico, la web, la seguridad, la monitorización y la gestión operativa.
En la práctica, recorre desde dentro muchos de los mismos procesos que se cuentan en este artículo, pero permite abrir los archivos y ver cómo estaban configurados realmente.
Entre las cosas que el archivo ha permitido reconstruir también hay procedimientos cotidianos que hoy han desaparecido por completo. Registrar un dominio, por ejemplo, era mucho más complicado que ahora. En el caso de los dominios .it, además, existían requisitos administrativos y técnicos especialmente estrictos.
En el repositorio se ha reconstruido todo el procedimiento, paso a paso, junto con algunos ejemplos reales de registros que realicé en aquella época como parte de Internet Force.
También se han incluido materiales menos relacionados con la infraestructura: el Welcome Kit que recibían los clientes, documentos y publicaciones de Usenet, materiales recuperados de los buzones de correo, los archivos fuente de la Guía de Internet y realidad virtual y otros fragmentos de la cultura técnica de aquellos años.
No porque todo formara parte del mismo «sistema», sino porque un proveedor de Internet no estaba compuesto únicamente por routers y daemons. También importaba cómo se aprendían, explicaban y utilizaban aquellas tecnologías.
Otras capas del archivo
En las copias de seguridad de mi estación de trabajo Linux de aquella época también han aparecido algunas carpetas originales de correo electrónico.
En ellas hay mensajes técnicos y listas de correo, agradecimientos de personas que habían descargado mi Guía de Internet y realidad virtual, conversaciones personales y las inevitables bromas frikis.
También han reaparecido los archivos fuente de la propia Guía de Internet y realidad virtual, junto con otros materiales relacionados con los experimentos que hacíamos entonces con la web y VRML.
En 1995-96, la realidad virtual en la web parecía una de las posibles direcciones hacia las que podía evolucionar Internet: mundos tridimensionales descritos mediante VRML que podían recorrerse desde el navegador con las herramientas de aquella época.
Volver a ver hoy aquellos archivos resulta interesante precisamente porque conservan no solo lo que era Internet, sino también algunas de las ideas que teníamos sobre lo que podía llegar a ser.
En esa misma copia de seguridad también ha reaparecido el material de un artículo que escribí en 1997, después de asistir a la DEFCON V de Las Vegas, una de las primeras ediciones de esta convención de hackers.
Es posterior al cierre de Internet Force y, por tanto, no forma parte de la historia del proveedor. Pero que haya permanecido en la misma copia de seguridad DAT refleja bastante bien otra característica de la arqueología digital: los archivos personales no respetan las fronteras entre empresas o proyectos. Simplemente siguen acumulando capas.
Al releerlos también aparece una diferencia que puede parecer insignificante: las firmas de los correos electrónicos.
En aquella época no solían ser esos bloques corporativos y estandarizados que vemos hoy, sino pequeñas declaraciones de identidad construidas con citas, lemas, arte ASCII o bromas. Incluso en las cuatro líneas del final de un mensaje se podía intuir la personalidad de quien lo escribía.
El repositorio es público y se puede consultar aquí: https://github.com/pippocom/internetforce-1995.
Si este artículo cuenta qué ocurría cuando un cliente se conectaba, allí se puede seguir el recorrido hasta los archivos de configuración y, si apetece, intentar entender cómo se construía realmente un proveedor de Internet en 1995.
El repositorio también incluye la guía Build an Internet Force POP, que explica paso a paso cómo se construía la infraestructura.
Por su parte, los mapas interactivos permiten explorar toda la red, la estructura de los POP y los detalles de los servidores centrales.
También hay un motivo más personal para haber publicado todo esto. Gran parte de lo que aprendimos entonces procedía de RFC públicas, código fuente que se podía consultar, preguntas frecuentes, listas de correo y debates técnicos abiertos.
Treinta años después, volver a poner esa infraestructura a disposición de cualquiera que quiera examinarla me parece una forma bastante natural de devolver a la red una parte de todo lo que la red me dio.
¿Qué fue de Internet Force?
La historia de la empresa fue bastante más corta que la de algunas partes de su red.
Internet Force terminó su actividad antes de lo previsto a finales de 1996. Sus socios pensaban que no era un negocio tan rentable como habían imaginado y decidieron cerrarlo justo antes de los años en los que Internet empezaría a crecer mucho más rápido también en Italia.
Pero el cierre de la empresa no significó que todo lo que se había construido se apagara sin más.
Me gusta pensar que, a pequeña escala, Internet Force había sembrado algo en las zonas donde había instalado sus POP. Llevar un punto de acceso local significaba desplegar infraestructura y conocimientos, pero también despertar una necesidad entre personas y empresas que hasta poco antes no habían tenido Internet al alcance de una llamada telefónica.
Cuando Internet Force cerró, algunos de aquellos nodos continuaron funcionando por su cuenta.
El POP de Gorgonzola siguió adelante como Pointest, que aparece mencionado posteriormente en una de las ediciones italianas de la Guía de Internet de la Electronic Frontier Foundation.
En Pesaro, por su parte, Pesaro Point continuó creciendo hasta convertirse en un proveedor de Internet regional. Unos años después, su web ya mostraba una red formada por nueve POP repartidos por la región de Las Marcas.
Son solo dos ejemplos, pero ayudan a que la fecha en la que debería terminar esta historia no parezca tan definitiva.
Internet Force desapareció como empresa antes de poder participar en el auge que estaba a punto de llegar. Sin embargo, algunos de los POP que había contribuido a poner en marcha siguieron creciendo precisamente durante ese periodo.
La empresa no llegó a recoger esos frutos, pero algunas semillas sí llegaron a germinar.
Qué puede enseñar un proveedor de Internet de 1995 a quienes desarrollan software hoy
Treinta años después, las tecnologías que utilizaba Internet Force pueden parecer rudimentarias. Sin embargo, al observar su arquitectura y sus decisiones operativas, aparece algo interesante: muchos de los problemas que hoy abordamos con plataformas cloud, herramientas DevOps e infraestructuras automatizadas ya estaban presentes entonces.
Las tecnologías cambian mucho más rápido que los problemas que tienen que resolver.
Para dar acceso a la red era necesario autenticar a los usuarios, gestionar permisos y coordinar distintos sistemas. Hoy hablamos de Identity and Access Management, federación de identidades y Zero Trust. Son arquitecturas y modelos de seguridad mucho más avanzados, pero también responden a necesidades que los proveedores de los años noventa ya conocían bien: saber quién accede, a qué recursos y con qué privilegios.
La separación de entornos tampoco nació con los contenedores. Compilar software en una máquina y distribuirlo en otra, limitar los servicios expuestos y diferenciar los entornos de trabajo de los operativos eran decisiones técnicas que podían tomarse mucho antes de que existieran las actuales pipelines de CI/CD.
La automatización ha cambiado radicalmente. La necesidad de controlar lo que se pone en producción, bastante menos.
Otra lección tiene que ver con la red. Hoy la observabilidad suele centrarse en aplicaciones, contenedores y métricas de los servicios. Pero para un proveedor de Internet la red no era una capa transparente: formaba parte del propio sistema y había que entenderla, configurarla y diagnosticarla.
Es un recordatorio que sigue vigente: monitorizar una aplicación sin comprender sus dependencias de red significa observar solo una parte del problema.
También está la importancia de los estándares abiertos y del software que se puede inspeccionar. Internet creció gracias a protocolos interoperables y a un ecosistema en el que era posible estudiar, modificar e integrar componentes de software.
Naturalmente, no todo era código abierto. Pero poder entender cómo funcionaban los sistemas, en lugar de tratarlos exclusivamente como cajas negras, era un recurso técnico fundamental. Y sigue siéndolo hoy, especialmente cuando evaluamos dependencias tecnológicas, seguridad y riesgos de vendor lock-in.
Por último, estos archivos nos recuerdan algo que a veces pasamos por alto: la documentación técnica también forma parte de la infraestructura, incluso cuando esa infraestructura ya no existe.
Las configuraciones, el código fuente, los scripts, los procedimientos operativos e incluso los errores permiten entender no solo cómo funcionaba un sistema, sino también por qué se tomaron determinadas decisiones.
Conservarlos permite reconstruir las limitaciones, los compromisos y las soluciones que, de otro modo, acabarían perdiéndose.
Conclusión: antes de que Internet simplemente «estuviera ahí»
Lo que más me ha llamado la atención durante esta reconstrucción no es lo primitivas que eran las tecnologías de 1995. Es justo lo contrario: muchos de los problemas siguen resultándonos sorprendentemente familiares.
Separar desarrollo y producción, reducir la superficie de ataque, centralizar la identidad, distribuir el acceso, monitorizar la red, definir políticas explícitas y evitar que quienes crean contenidos publiquen directamente en los sistemas de producción.
Son problemas que seguimos resolviendo hoy con herramientas mucho más potentes y, de vez en cuando, con diagramas bastante más bonitos.
La diferencia es que entonces los límites eran visibles.
Una conexión ocupaba un módem. Un POP era un par de routers y un rack de líneas telefónicas. El correo electrónico era un proceso que se ejecutaba en una máquina que podías señalar con el dedo.
Si el DNS no funcionaba, sabías qué daemon tenías que revisar. Y si querías entender Internet, tarde o temprano acababas leyendo una RFC o un archivo de configuración.
Por eso considero que estas copias de seguridad son una pequeña forma de arqueología digital.
Por separado, son restos: una ruta, un archivo de zona DNS, una política, un directorio FTP o el nombre de un Macintosh. Pero, cuando los vuelves a situar en su contexto, cuentan algo mucho más grande: la historia de una comunidad de usuarios, una oficina, una redacción y una red que cada día transformaba llamadas telefónicas analógicas en acceso a Internet.
Volver a poner en circulación los rastros de una Internet en la que la infraestructura técnica y la comunidad que la construía estaban mucho más conectadas entre sí significa devolver hoy a la red una parte del conocimiento que la red me dio.
Antes de que Internet se convirtiera en algo que simplemente «está ahí», alguien tenía que construirla.
Un módem, un daemon y una regla de routing cada vez.