Negli ultimi due anni gli assistenti AI per scrivere codice sono entrati nella vita di praticamente tutti noi, con buona pace di chi giurava che non li avrebbe mai usati (ciao, sono anche io, ex scettico redento). Funzionano che è una meraviglia su HTML, CSS, JavaScript semplice, funzioni pure. Poi gli dai in pasto un componente React con cinque hook che si parlano tra loro, o un computed() di Vue agganciato a uno stato mutato tre file più in là, e all’improvviso l’assistente sembra aver bevuto.
Non è un’impressione raccolta al bar dopo un meetup. C’è una ragione precisa, ed è la stessa ragione per cui quei framework mettono in difficoltà anche noi umani: solo che a noi, con l’esperienza, è rimasto il callo mentale per evitare certe trappole. Un modello quel callo non ce l’ha, e quindi ci casca con entusiasmo.
Il problema non è la sintassi, è la magia
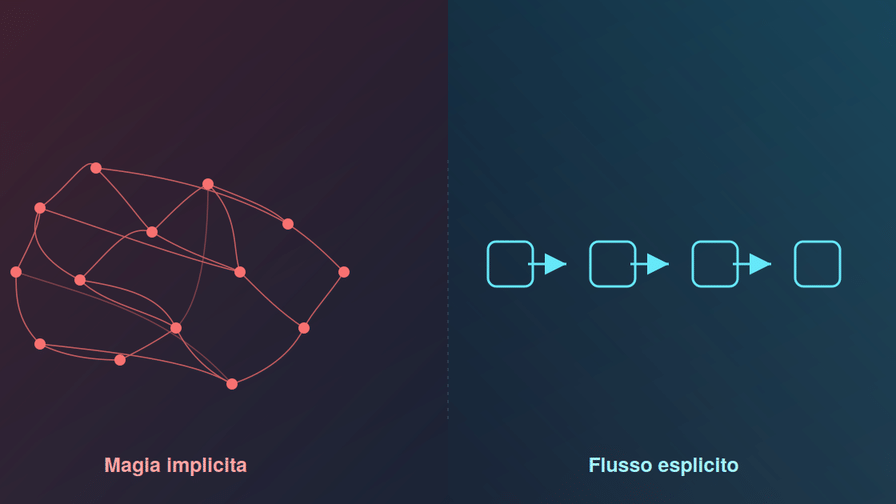
I modelli linguistici generano codice prevedendo il prossimo pezzo di testo in base a quello che vedono intorno. Funzionano bene quando il comportamento è deducibile da quello che hanno davanti agli occhi: una funzione pura si spiega da sola, guardi l’input e l’output e hai finito. Funzionano male quando il comportamento dipende da qualcosa che non è scritto da nessuna parte nel file che stanno leggendo in quel momento.
Negli ultimi anni i web framework reattivi hanno tutti tirato dritto nella stessa direzione: più magia automatica, meno codice da scrivere a mano, tutto molto comodo finché funziona. Per uno sviluppatore esperto è spesso un figurone: tre righe e il grafo di aggiornamenti si costruisce da solo. Per un modello che deve generare codice corretto senza poter eseguire mentalmente quel grafo invisibile, è una gara a ostacoli al buio.
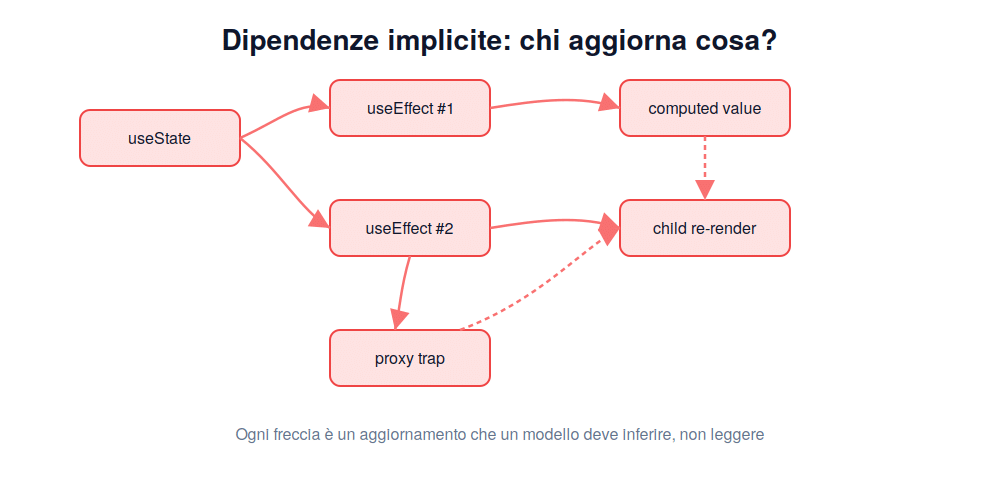
Un esempio pratico. In Vue 3, destrutturare un oggetto reattivo spegne silenziosamente la reattività:
const state = reactive({ count: 0 })

// Smette di aggiornarsi. Nessun errore, nessun warning, solo silenzio
const { count } = state

// Questo invece va benissimo
const count = computed(() => state.count)Code language: JavaScript (javascript)
Chi usa Vue da un po’ lo sa e lo evita quasi per riflesso spinale. Un modello che genera codice plausibile basandosi su pattern comuni di JavaScript, dove destrutturare un oggetto è innocuo al 99% dei casi, ci casca eccome. E la stessa storia si ripete, con varianti sul tema, per gli array di dipendenze di useEffect in React (ne dimentichi una e hai un bug silenzioso, ne metti una di troppo e hai un loop) o per il tracking automatico di computed().
Allargando la famiglia: Solid e Angular
A chi insiste che “eh ma i segnali di Solid sono solo un get/set, mica è magia” rispondo: è vero finché leggi un segnale isolato. Il problema comincia quando lo componi. Un memo o un effect in Solid tiene traccia, a runtime, di quali segnali ha letto durante la propria esecuzione, senza che tu lo dichiari da nessuna parte. È lo stesso principio del tracking automatico di Vue, solo spostato di un piano. E quando un segnale ne scatena un altro, che scatena un effetto, che riscrive il primo segnale, il grafo di propagazione non è scritto in nessun punto del codice: va ricostruito seguendo letture e scritture a runtime. Per un modello è un indovinello della stessa famiglia di quello di Vue, solo con un vestito diverso.
Angular, per completezza, riesce nell’impresa di soffrire di due mali insieme. Da un lato ha abbracciato anche lui i segnali in stile Solid, portandosi dietro lo stesso tracking implicito. Dall’altro continua a essere Angular: decoratori, dependency injection, moduli, e una verbosità che definire “generosa” è un eufemismo.
Qui qualcuno obietterà: con context window ormai da centinaia di migliaia di token, chi se ne frega se Angular è verboso, tanto lo spazio ormai c’è. Vero, ma non è quello il punto. Il problema non è più “finisce la memoria”, è la densità di segnale rispetto al rumore. Duecento righe di boilerplate per dire “questo componente riceve un input e ne espone un output” significano duecento righe in cui il modello deve distribuire la propria attenzione, e la logica di business che conta davvero finisce diluita in mezzo a decoratori, provider e configurazione ripetitiva. È lo stesso fenomeno noto come “lost in the middle”: più rumore attorno al dettaglio critico, più probabilità che quel dettaglio venga trattato con meno attenzione, non perché manchi lo spazio ma perché la densità informativa è bassa. Risultato pratico: più probabilità di perdere il filo tra un decoratore e l’altro, soprattutto in file lunghi.
Perché gli standard web se la cavano meglio
Gli assistenti AI generano codice migliore su HTML, CSS e JavaScript piatto per lo stesso identico motivo per cui faticano sui framework più “magici”: meno inferenza serve per prevedere cosa succede, meglio è. Una funzione che prende uno stato e ne restituisce uno nuovo è un libro aperto. Un gestore di eventi che fa esattamente quello che dichiara di fare, idem. Un sistema che traccia dipendenze origliando quali variabili vengono lette durante un’esecuzione, molto meno.
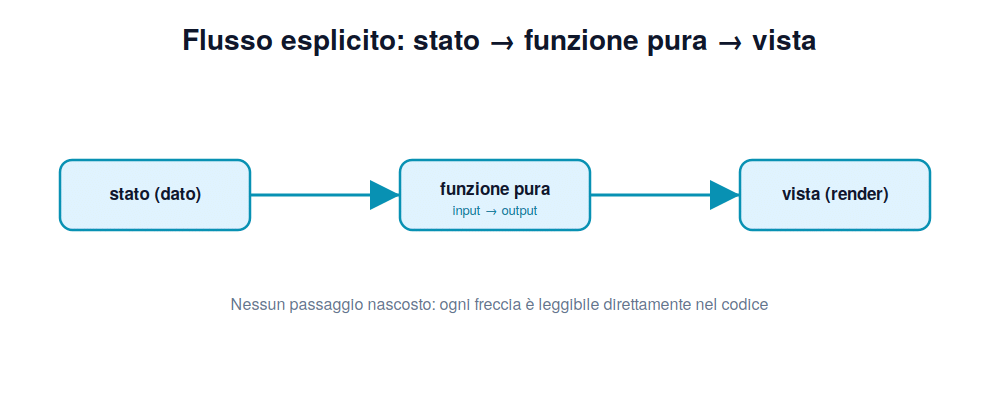
Non è un attacco ai web framework in sé, sia chiaro: React, Vue, Svelte, Solid e Angular restano strumenti potenti, usati con successo su scala enorme, e nessuno sta proponendo di tornare a scrivere siti con document.write. È un’osservazione su un compromesso che finora abbiamo valutato quasi solo dal punto di vista umano (quanto scrivo, quanto è comodo) e che oggi merita di essere guardato anche dal punto di vista di chi, sempre più spesso, quel codice lo scrive in coppia con un modello, o lo fa scrivere direttamente a lui.
Cosa significa in pratica, oggi
Qualche euristica che uso io stesso quando lavoro con un assistente AI.
Più un framework nasconde “a chi tocca aggiornarsi quando cambia cosa”, più il codice generato va riletto con attenzione. Hook di React, composable di Vue e computation di Solid sono i candidati ideali per bug sottili infilati dall’AI senza cattiveria, solo per ignoranza del contesto implicito.
Il codice esplicito è più facile da verificare anche per un modello, non solo per un umano. Un buon test: chiedi all’AI di spiegare perché un pezzo di codice fa quello che fa. Se la spiegazione richiede di indovinare comportamento invisibile nel file che hai sotto gli occhi, hai trovato un punto delicato, e non solo per l’AI: lo sarà anche per il collega che aprirà quel file fra sei mesi senza il contesto in testa.
Alcuni progetti stanno scommettendo apertamente su architetture più esplicite (stato come dato semplice, rendering come funzione pura, zero proxy o compilatori di mezzo) proprio per restare leggibili sia da umani sia da macchine. Inglorious Web, il framework open source a cui lavoro, è uno di questi tentativi, ma non certo l’unico: la stessa logica guida da tempo librerie minimaliste come Alpine.js o approcci “HTML-first” come Htmx. Che questa strada diventi la norma o resti una nicchia per irriducibili, è comunque un segnale di dove si sta spostando parte della conversazione sull’architettura frontend in questo periodo.
Una domanda aperta (e nessuna crociata)
Non sto suggerendo di tornare tutti al JavaScript vanilla scritto a mano come nel 2010, magari con jQuery per completare l’opera nostalgica. I framework “magici” offrono vantaggi reali in produttività umana, che gli standard nudi non replicano facilmente, e per tanti team il compromesso continua a valerne la pena.
Ma vale la pena chiedersi se, scegliendo un’architettura oggi, il criterio “quanto è leggibile e prevedibile anche per un modello” debba iniziare a pesare quanto “quanto è comodo per un umano esperto”. Perché nel 2026 il codice sempre più spesso non nasce più da un solo autore umano che si porta dietro tutte le trappole a memoria: nasce da un umano e un modello che lavorano fianco a fianco, e la leggibilità per entrambi smette di essere un vezzo stilistico. Diventa una proprietà dell’architettura stessa, con buona pace della magia.