Cosa succede quando un modello nato per prevedere serie temporali si trova davanti a due scenari lontanissimi: la classifica della Serie A e gli scaffali di un magazzino? Ho provato a scoprirlo con due modelli fondazionali gratuiti, creati da aziende diverse.
Il primo è TimesFM 3.0 di Google, usato per il calcio: zero-shot, su serie corte e rumorose. Il secondo è Timestral-209M di Mistral, usato per le vendite: sempre zero-shot, ma su serie lunghe, con stagionalità e informazioni note in anticipo. Sono anche concorrenti diretti: nella scheda di Mistral Timestral precede di poco TimesFM-3, insieme a Chronos-2, Toto-2.0 e t0-gamma.

Non cerco però il modello migliore in assoluto: cerco di capire cosa cambia quando un foundation model incontra il terreno giusto o quello sbagliato. Una nota sulle licenze: entrambi sono gratuiti per sperimentare, ma TimesFM è per uso non commerciale, mentre Timestral è in anteprima pubblica con una licenza MIT modificata che prevede una soglia di fatturato.
Primo esperimento: 38 giornate di caos
Undici stagioni di Serie A, un modello di Google da 1,32 GB e la domanda più semplice del mondo: chi arriva davanti?
Tutti, al bar, proviamo a indovinare la classifica finale. Questa volta l’ha fatto un modello nato per prevedere vendite, sensori e meteo. Il racconto è dall’interno, con numeri veri e limiti dichiarati. E una domanda sullo sfondo: se sa prevedere una classifica di calcio, cosa sa fare su dati che contano per un’azienda?
Cos’è TimesFM
Come ChatGPT prevede la prossima parola, TimesFM prevede il prossimo valore di una serie. Nato in Google Research e rilasciato in open source, ne usiamo la versione 3.0 di Hugging Face, un file da 1,32 GB. Lavora in zero-shot: non lo riaddestriamo sul calcio, gli diamo la storia e chiediamo il futuro.
Due dettagli utili. Legge la storia a blocchi da 32 punti (patching), e per questo con poche giornate alle spalle è praticamente cieco. E restituisce quantili: non dice solo «85 punti», ma «85, con una banda tra 80 e 90».
Perché il calcio è un test bastardo
La serie è cortissima: 38 giornate per squadra, altro che migliaia di righe di vendite. I risultati saltano tra 0, 1 e 3, e ogni anno promozioni e retrocessioni cambiano i protagonisti. Il trucco è trasformare i risultati in punti cumulati (3, 3, 6, 9…), una linea che sale e che si presta meglio a un modello di serie temporali.
L’obiettivo: a G10 (giornata 10), G19, G25 e G30, prevedere i punti finali e l’ordine di classifica. Qui non ci sono stagionalità pulite né covariate prevedibili, ed è proprio il contrasto con la seconda sezione di questo articolo.
I dati
Undici stagioni complete, dal 2015/16 al 2025/26: 4.180 partite, nello schema di Football-Data.co.uk. Più la stagione in corso, 2026/27: 100 partite dopo la decima giornata (al 2 novembre 2026), giorno di stesura di questo articolo e quindi data della previsione.
La pulizia ha riguardato date in due formati; le stagioni in corso sono escluse dall’addestramento. Per chi vuole replicare, ne escono 2.200 finestre con 19 giornate di contesto e 10 di orizzonte.
Gli avversari e come li misuriamo
Quattro metodi a confronto, senza formule:
- Proporzione semplice: «se hai 10 punti in 10 giornate, finirai a 38».
- Media delle ultime 5: guarda solo l’ultimo periodo.
- Modello esperto (una regressione Ridge di scikit-learn): impara dagli 11 campionati usando punti, gol fatti e subiti, differenza reti e posizione.
- TimesFM zero-shot: gli diamo la serie cumulata e chiediamo i punti finali.
C’è anche un ensemble, 80% modello esperto e 20% TimesFM, per unire precisione e bande di incertezza. Le metriche: l’errore medio in punti (MAE), la qualità dell’ordine (correlazione di Spearman) e la quota di Top 4 azzeccate. Attenzione: quest’ultima è una frequenza storica su 11 stagioni, non una probabilità calibrata sul singolo campionato.
Cosa è successo: i numeri
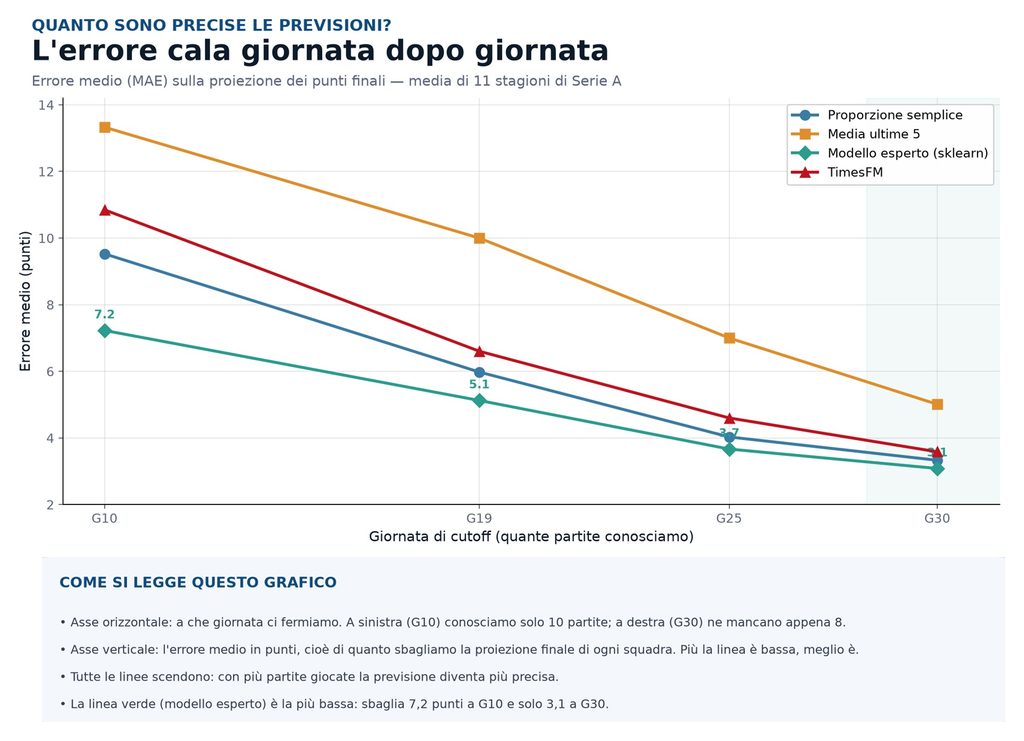
Errore medio in punti sulle 11 stagioni (più basso è meglio):
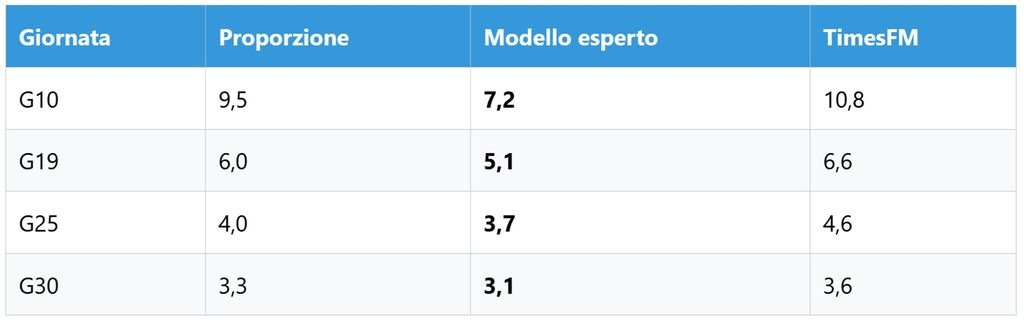
Il modello esperto vince sempre in media; TimesFM parte male ma si avvicina nel finale. A G19 l’ordine è già solido (Spearman 0,91) e le Top 4 sono azzeccate nel 79,5% delle stagioni. Esempio 2025/26: a G19 l’Inter, che chiuderà a 87, era prevista a 83,4; a G30 TimesFM fa meglio di tutti su quella singola stagione, con un errore di 2,57.
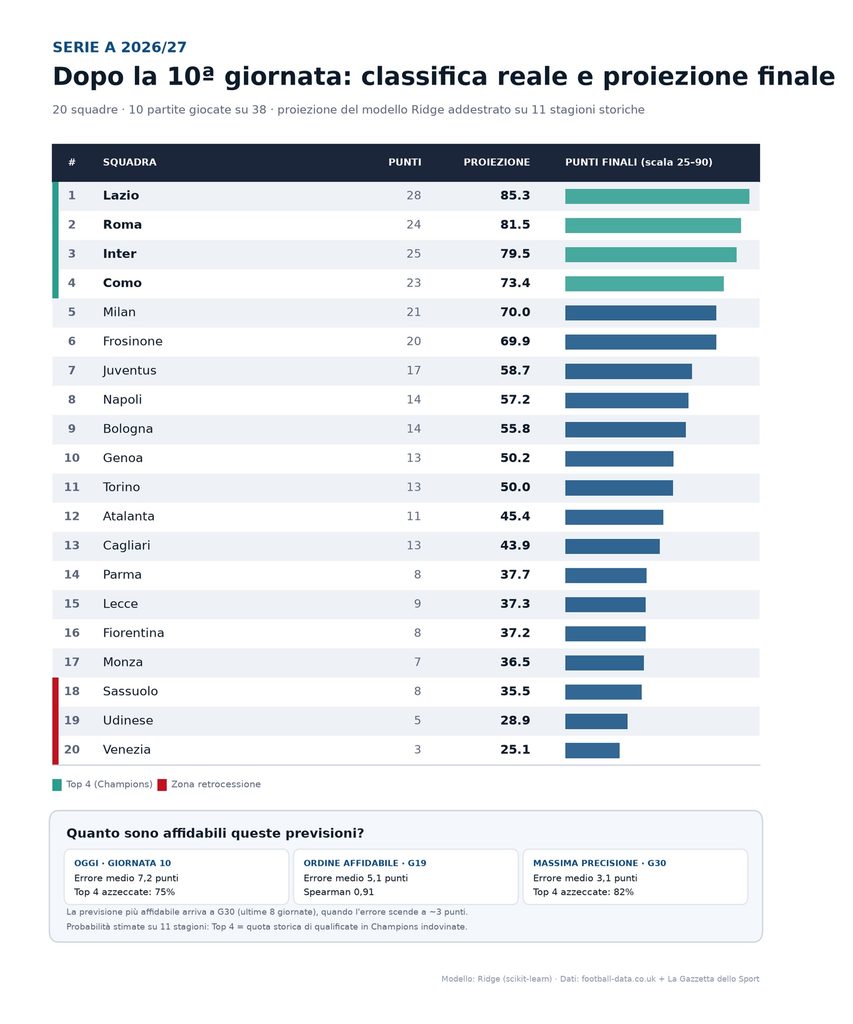
La classifica di oggi (2026/27)
Dopo dieci giornate: Lazio 28, Inter 25, Roma 24, Como 23, Milan 21, Frosinone 20, Juventus 17, Napoli e Bologna 14. La proiezione del modello esperto a fine stagione: Lazio 85,3, Roma 81,5, Inter 79,5, Como 73,4, Milan 70,0. A G10 l’errore storico è di ±7,2 punti, quindi queste cifre vanno lette come zone, non come sentenze.
Curiosità: a G10 TimesFM darebbe 105 punti alla Lazio e 3 al Venezia. Per questo, sotto G10, la sua colonna è solo documentale.
Dove inciampa
Con poche giornate è cieco. Con 2-10 giornate non ha abbastanza memoria, e a G1 l’errore esplode. Il calcio è rumoroso: un gol all’ultimo minuto vale 3 punti o 0, e non c’è la stagionalità pulita delle vendite. Troppo pochi esempi: 2.200 finestre per un modello enorme; ho valutato il fine-tuning e l’ho scartato (rischio di overfitting, guadagno atteso sotto il punto di MAE).
E a volte basta la cosa più semplice: proporzione e modello esperto sono quasi imbattibili a inizio stagione. TimesFM non è scarso: è fuori dal suo terreno ideale. Un foundation model non è automaticamente la risposta.
Cosa resta utile
Anche quando non vince, TimesFM regala le bande di incertezza: «Lazio tra 80 e 90», non un numero secco. La previsione più affidabile arriva a G30 (errore di circa 3,1 punti, Top 4 all’82%); già a G19 l’ordine è credibile. A G10 siamo a ±7,2 punti. Morale: su un campionato corto e rumoroso un ragionamento semplice e specializzato spesso batte il modello gigante, che però ti dice quanto è incerto.
Dallo stadio al magazzino
Va bene, il calcio è un gioco. Ma su una serie lunga, stagionale e con soldi veri, un altro modello fondazionale come se la cava? Cambiamo protagonista: da TimesFM di Google a Timestral-209M di Mistral. I due esperimenti non sono confrontabili punto a punto, perché giocano su campi diversi: per me erano la scusa per provare un altro modello open weight.
Timestral-209M: prevedere senza studiare
Immaginate un magazzino con tremila referenze e un responsabile che, il lunedì mattina, deve decidere quanti pallet ordinare e quanti addetti convocare. Nessuno gli chiede di leggere il futuro: gli serve una stima condizionata, un ventaglio di domani plausibili. Qui lo scenario è opposto al calcio: serie lunghe, stagionalità, covariate note in anticipo, errore che si paga in unità vendute. La tesi, subito: Timestral batte una baseline ingenua, ma non è una prova definitiva di superiorità.
Anatomia essenziale
Timestral è una famiglia di quattro modelli da 5, 28, 123 e 209 milioni di parametri, rilasciati da Mistral a metà ottobre 2026, pensati per girare anche su una CPU ordinaria. Dalla scheda ufficiale: legge fino a 32.768 passi di storico, guarda avanti fino a 1.024 passi in un colpo solo, produce 21 quantili e accetta covariate come calendario, prezzi o festività note in anticipo.
La parte più curiosa è l’addestramento: in gran parte su dati sintetici, processi con tendenze, stagionalità e rumori generati ad arte. Cosa ci sia nel corpus reale non è dichiarato, e il rapporto tecnico è «in arrivo». Quanto alla licenza, nega l’uso a chi supera i 20 milioni di dollari di fatturato mensile consolidato, salvo accordo con Mistral: non è una royalty, è una soglia d’ingresso.
Promesse da verificare
Mistral dichiara il primo posto tra i modelli zero-shot su GIFT-Eval, TIME e fev-bench. Su GIFT-Eval il MASE è 0,658 contro 0,661 di t0-gamma: margini reali ma piccoli, e dichiarati dal produttore, senza replica indipendente. Il problema di fondo delle classifiche lo ricorda Rob Hyndman: confronti spesso fatti con metodi statistici poco curati e un rischio di contaminazione, dato che solo il 6% dei dataset usati da 22 modelli fondazionali non era mai comparso in alcun addestramento. Chi ha visto Primer sa cosa succede quando un’informazione viaggia indietro nel tempo senza che nessuno se ne accorga.
Come abbiamo fatto la prova
Tutto in una cartella di progetto, con una pipeline ripetibile. Dal dataset M5 di Walmart (vendite, calendario, prezzi) abbiamo estratto 300 serie prodotto-negozio con campionamento stratificato: 120 ad alto volume, 120 a volume medio, 60 a basso volume o intermittenti. Tre finestre consecutive da 28 giorni, dal 1 febbraio al 24 aprile 2016, ciascuna con 365 giorni di storico: i valori reali non sono mai entrati nella previsione. Gli ultimi 28 giorni (la parte finale del grafico), sono stati tenuti fuori dai dati mostrati per generare la previsione, in modo da avere un confronto pulito tra previsione e dati reali già disponibili. Timestral lavora zero-shot, su CPU, con covariate note (giorno della settimana, mese, weekend, eventi, giorni SNAP, prezzo). Il riferimento è la previsione stagionale ingenua: ripete il valore dello stesso giorno della settimana precedente.
È una prova casalinga, non un benchmark: la metrica ufficiale della gara, il WRMSSE, non è calcolata, quindi nessun confronto con la classifica originale.
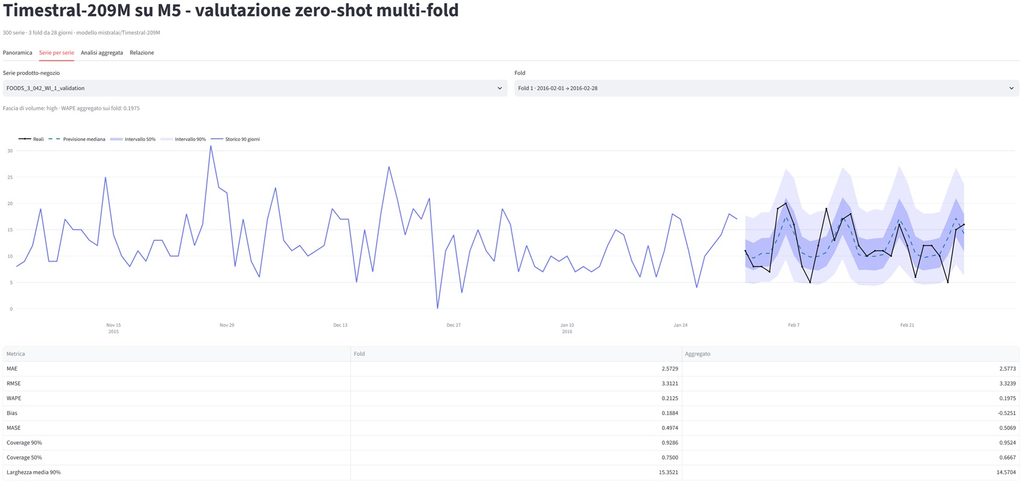
Numeri sotto esame
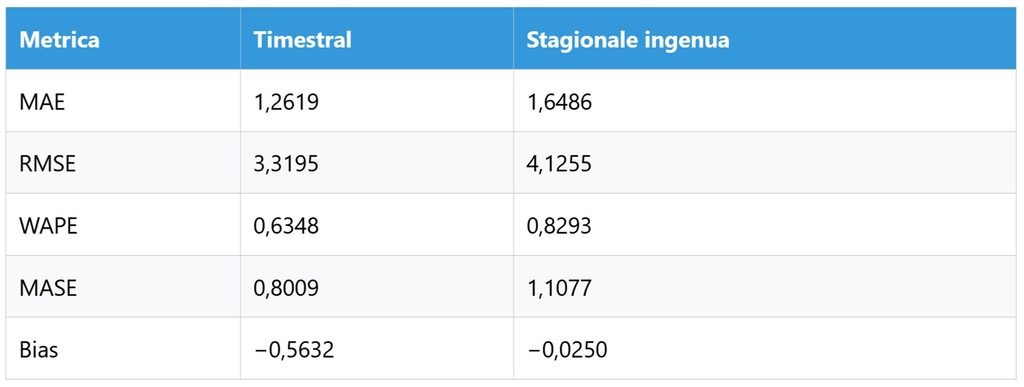
Il WAPE è l’errore totale diviso per le vendite totali: 0,6348 non significa «accuratezza del 63%», ma un errore pari al 63% del venduto. Contro la baseline, Timestral migliora il WAPE del 23,45%, il MAE del 23,46%, l’RMSE del 19,54% e il MASE del 27,70% (0,80 contro 1,11), con lo stesso segno nelle tre finestre. Ma le cautele pesano. Sul WAPE gli intervalli di confidenza al 95% sono ben separati (0,5883–0,6917 contro 0,7610–0,9059); su RMSE e MAE si sovrappongono o sfiorano la sovrapposizione, e il vantaggio non è dimostrato.
Il bias è il difetto da non nascondere. Vale −0,5632: sottostima sistematica, circa il 28% di vendite medie di due unità al giorno (contro −0,025 della baseline). Per chi gestisce scorte è il difetto peggiore, perché porta a restare senza merce. Gli intervalli sono invece conservativi: quello al 90% copre il 93,30% dei casi, quello al 50% arriva al 62,62%, dodici punti sopra il nominale; su dati pieni di zeri la copertura è gonfiata, e senza un riferimento equivalente non sappiamo se siano buoni o solo larghi.
Per volume, sulle 120 serie ad alto volume il WAPE è 0,5845 contro 0,7518; sul volume medio 0,8708 contro 1,1684. Sulle 60 intermittenti il miglioramento del 40,62% (1,0069 contro 1,6956) è ingannevole: un WAPE sopra 1 è peggiore di una previsione di soli zeri. I singoli casi lo confermano: un prodotto tra i «migliori» per WAPE ha MASE 1,4251, peggio della baseline, e il peggiore vende circa 0,012 unità al giorno. Gli zeri di M5 non sono sempre domanda assente.
I limiti: 300 serie su oltre 30.000, 84 giorni, nessuna covariata promozionale, un solo riferimento semplice, nessun confronto con ARIMA, ETS o altri modelli fondazionali, e M5 è pubblico dal 2020, quindi non escludo la contaminazione. In parole semplici: un buon risultato zero-shot, chiaramente migliore di una regola elementare, ma non la prova che Timestral sia il modello da scegliere.
In due parole. Timestral è come un meteorologo che, in tre mesi di prova, ha sbagliato un quarto in meno di chi si limita a dire «domani sarà come lunedì scorso». Bravo, ma con un vizio: è prudente fino all’avarizia e tende a riempire il carrello di meno di quanto serve, così il rischio è trovare lo scaffale vuoto. Gli ombrelli che offre «per sicurezza» sono larghissimi, e sui prodotti che si vendono una volta ogni tanto è come cercare di prevedere il lancio di un dado: qui anche il migliore va a tentoni. Un buon allievo, dunque, non ancora un campione da mandare in cabina di regia.
Chi lo usa, chi no
Mistral cita sensori industriali, finanza, energia e supply chain; il retail è coperto soltanto dalla nostra prova. Il valore è evidente dove ci sono molte serie, poche risorse statistiche e covariate ricche. Serve meno con poche serie, relazioni causali note, spiegabilità obbligatoria. Il consiglio di Hyndman: partire da un riferimento statistico ben fatto, provare sui propri dati con finestre mobili e pesare il costo totale, licenza compresa.
Più accessibile, non magica
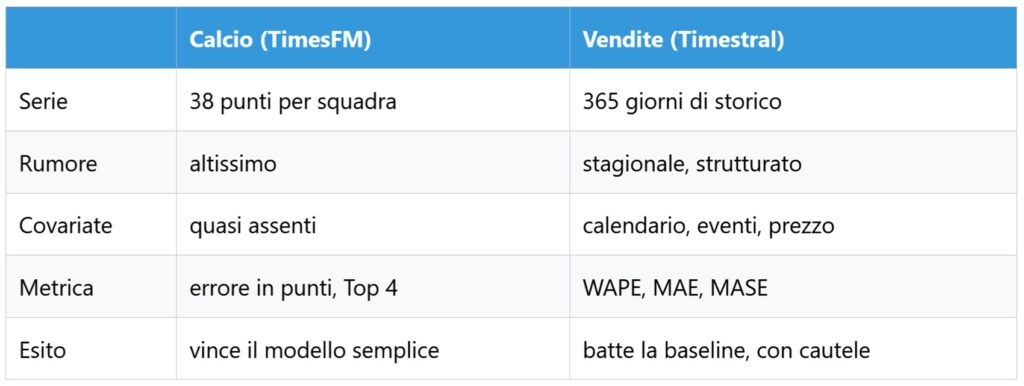
Messi uno accanto all’altro, i due esperimenti dicono la stessa cosa da lati opposti. Nel calcio, un terreno corto e rumoroso, TimesFM non vince: vince il modello semplice e specializzato, e il gigante regala almeno l’incertezza. Nelle vendite, con storia lunga e covariate, Timestral batte la baseline in modo coerente, ma sottostima, ha intervalli larghi e un campione limitato. Nessuno dei due «ha vinto» in assoluto: dipende da giornata, dataset e metrica.
La previsione non è diventata magia. È diventata più accessibile.