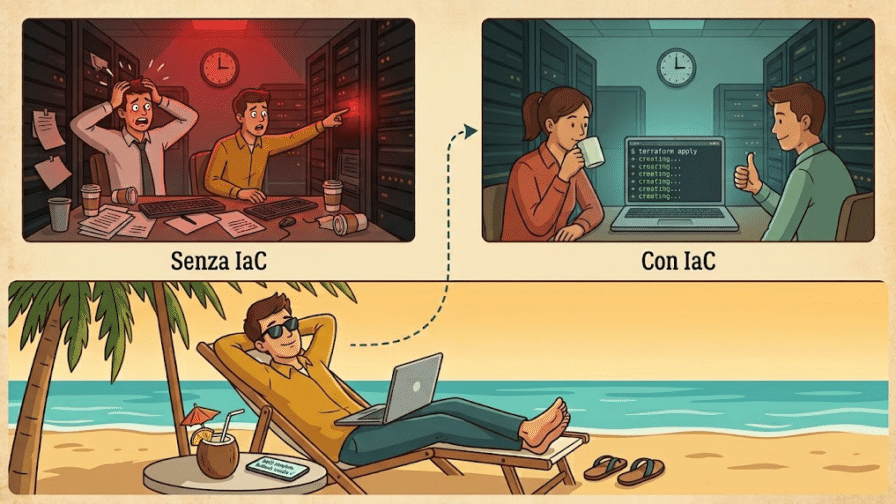
Infrastructure as code (IaC) è il modo per gestire e provvisionare infrastrutture attraverso il codice, invece che farlo manualmente. Un concetto, all’epoca ma tuttora, rivoluzionario nel design e nella gestione di infrastrutture informatiche.
Pensando a quanto sia più naturale scrivere, in relativamente pochi file, la configurazione di una rete, il provisioning di alcune macchine, la gestione dei dischi e dello scaling, senza dover fare venti click e ricordarsi ogni singolo passaggio, si capisce subito perché sia stato un cambio di paradigma.

Definire l’infrastruttura attraverso il codice, e conservarla in file, rende più facile generarla, scriverla e distribuirla. Ma c’è di più: quel codice diventa anche la documentazione stessa. Non serve andare a cercare dentro documenti quali macchine esistono o come sono collegate le reti, basta leggere i file o forgiare degli output in modo furbo e sono sempre allineati con quello che gira davvero, perché è da lì che nasce l’infrastruttura. In più, tutto questo si può versionare.
Abbandonare un approccio manuale ed abbracciare questo tipo di gestione porta con sé molti benefici:
- la capacità di creare infrastruttura immutabili
- garantire riproducibilità del sistema
- ridurre l’impatto dell’errore umano
- aumentare il livello di comprensione e condivisione della conoscenza
- aumentare l’organizzazione e gestione di risorse in gruppi
- abilita il versioneamento e la possibilità di utilizzare analisi di codice statico.
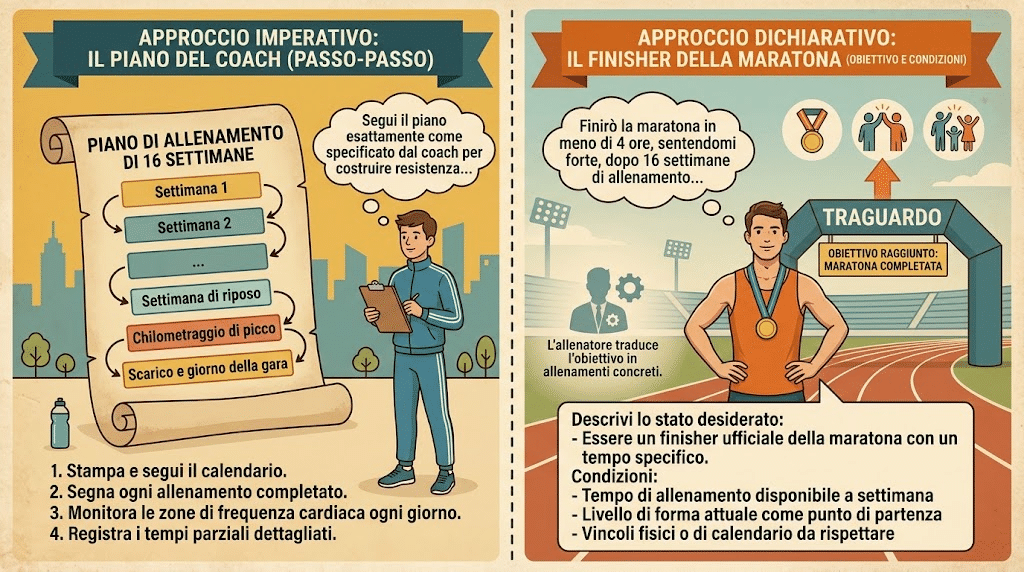
Per scegliere uno strumento in modo consapevole e non dettato dalla moda del momento, conviene prima capire che esistono principalmente due tipi di approccio, imperativo e dichiarativo, ciascuno con vantaggi e compromessi diversi.
Nell’approccio imperativo si opera ad un livello di astrazione più basso e vengono definiti i comandi da eseguire per raggiungere lo stato che vogliamo; quasi come una ricetta da seguire. Questo approccio aiuta ad avere una maggiore capacità di implementare logiche complesse e rendere procedure di troubleshooting più semplici, ma comporta un impatto maggiore del fattore umano e minore opportunità di collaborazione.
Nell’approccio dichiarativo, invece, non descriviamo il percorso, ma la destinazione che vogliamo raggiungere. Dichiarando lo stato desiderato del sistema, lo strumento ha il compito di dedurre come arrivarci; l’astrazione è alta, la scrittura del codice più veloce e il fattore umano incide meno non dovendo pensare ogni singola azione, il lato negativo è che si complicano le attività di troubleshooting.
Ci sono casi in cui gli strumenti usano entrambi gli approcci.
L’utilizzo del infrastructure as code abilita direttamente le metriche DORA:
- Deployment Frequency: passando da un processo manuale ad uno automatizzato ed inserito all’interno di pipeline di CI/CD permette di creare, modificare o distruggere ambienti in pochi minuti e in modo più frequente. Quindi, rendendo possibile misurare questo tipo di attività.
- Lead Time for Changes: una modifica all’infrastruttura passa dallo stesso ciclo di review e deploy del codice applicativo, quindi il tempo tra una richiesta di cambiamento e la sua messa in produzione si riduce drasticamente.
- Mean Time to Recover / Restore: in caso di problemi consente di ricostruire l’intera infrastruttura da zero in modo rapido oppure di effettuare un rollback, potenzialmente ampliando la platea di persone che possono innescare il restore.
- Change Failure Rate: riducendo l’intervento manuale, si riducono gli errori umani e si limita il configuration drift. O comunque si è in grado di misurarli.
Questi elementi, messi insieme, mostrano perché adottare IaC non è solo una scelta tecnica, ma un abilitatore di efficienza ed efficacia. Ma quando ha senso valutare davvero l’adozione?
Quando usarlo?
Già dalle righe qui sopra possiamo intuire come la riduzione della distanza tra gli sviluppatori e la fornitura di infrastrutture sia una pratica interessante e in grado di fornire velocità, consistenza e sicurezza; riducendo gli errori e il tempo necessario per avere un’infrastruttura pronta.
Prima si abbraccia questo modo di gestire le infrastrutture e prima si crea una storia, grazie a git, evolutiva della stessa: lo stato desiderato oggi è questo, ma cosa ci ha portato qui? l’infrastruttura è sempre stata questa? È nata bene o sono stati necessari dei fix? Quali? Così facendo, oltre ad avere una “memoria storica” condivisa, la conoscenza non resta in mano a una sola persona, che magari domani non c’è più: può essere acquisita anche da qualcun altro, magari con più lentezza, ma si aumentano le possibilità di riuscirci. E questo rende più facile imparare dagli errori fatti, o permette ad altri di non farli nuovamente.
In più riusciamo ad avere uno storico di quando una riga di codice è cambiata, ma chi è l’autore e magari il numero del task assegnato (così da avere maggiori informazioni).
E avendo tutta questa storia scritta in codice, possiamo fare un passo oltre: usare l’AI per interrogarla. Invece di scavare a mano tra commit e pull request, si può chiedere direttamente “com’è stata configurata questa subnet” o “quali modifiche hanno preceduto quell’incidente”, e ottenere una risposta contestualizzata. L’inserimento di una persona in un progetto diventa più semplice: non deve solo leggere la documentazione, può interrogarla.
Per come la vedo io, questa è una cosa da avere subito. Un’azienda moderna non può prescindere da questa modalità.
Quando non usarlo?
Vedi paragrafo precedente, non scherziamo! Se proprio devo trovare un’eccezione, è quella di una startup alle primissime armi, magari con due server buttati sulla scrivania solo per validare un’idea prima ancora di avere un prodotto vero. In quel caso, un po’ di caos manuale può starci. Ma onestamente, anche quella fase dura pochissimo: appena superi il prototipo, la scusa finisce lì.
Sei nuovo, o indeciso? Facciamoci due domande
Prima di passare agli strumenti, prova a rispondere onestamente:
- Sapresti dire, senza aprire una console, quali risorse esistono oggi nel tuo ambiente?
- Se un server sparisse stanotte, sapresti ricostruirlo in pochi minuti, o servirebbero ore e la memoria di chi lo ha configurato a mano?
- Quando cambi qualcosa in produzione, quella modifica resta scritta da qualche parte, o vive solo nella tua testa?
- Il resto del team saprebbe rispondere a queste domande come te, o sei l’unico punto di riferimento?
Se ti sei riconosciuto più nella seconda metà di ogni domanda, IaC è la prossima cosa da imparare.
Chi fa il lavoro sporco?
Il panorama è particolarmente ampio e dipende da quale parte si vuole automatizzare: la maggior parte di questi strumenti adotta comunque un approccio dichiarativo, anche se il modo in cui lo esprimono, e quanto spazio lasciano a chi scrive codice, può fare una grande differenza, come vedremo tra poco.
Per esempio, per quanto riguarda il provisioning di macchine virtuali, subnet di rete e altre risorse cloud, i nomi più gettonati sono due: Terraform e Pulumi, entrambi pensati per essere agnostici rispetto al cloud provider, quindi utilizzabili sia su AWS che su Azure o Google Cloud con la stessa sintassi di base. Poi ci sono le soluzioni native di ciascun provider: AWS ha CDK e CloudFormation, Azure ha Bicep, Google mette a disposizione strumenti basati su una logica simile a Terraform. La differenza principale tra i due gruppi è che gli strumenti agnostici permettono di gestire ambienti multi-cloud con un solo linguaggio, mentre quelli nativi sono più integrati con l’ecosistema del provider, ma ti legano a quello.
Io sono particolarmente affezionata a Terraform, ma negli ultimi anni mi sono avvicinata molto a Pulumi. La motivazione principale è perchè avevo necessità di superare i limiti espressivi di HCL. Per quanto HCL sia potente (e con OpenTofu alcune cose sono migliorate N.d.A.), l’ho trovato “rigido” di fronte ad architetture complesse. Adottando Pulumi ho trovato la potenza espressiva di cui avevo bisogno e avvicina ulteriormente il codice di infrastruttura ad una platea di sviluppatori.
IaC letto attraverso CAMS
L’Infrastructure as Code (IaC) si integra perfettamente nei principi del modello CAMS, fungendo da vero e proprio abilitatore DevOps. Codificare l’infrastruttura promuove una Cultura di responsabilità condivisa tra sviluppatori e gestioni operative. Allo stesso tempo, si sposa appieno con il pilastro dell’Automazione, consentendo di automatizzare l’intero ciclo di vita delle risorse, dal provisioning alla configurazione, ed eliminando i processi manuali soggetti a errori. Trattare l’infrastruttura come codice semplifica enormemente la Misurazione, poiché rende ogni modifica tacciabile, verificabile e facilmente integrabile con strumenti di monitoraggio e compliance. Infine, l’uso di repository di codice favorisce la condivisione, rendendo l’architettura accessibile e comprensibile a un pubblico più ampio. Le infrastrutture diventano codice che le persone possono verificare, testare e approvare.
Alla fine, la domanda non è se adottare l’Infrastructure as Code, ma quanto tempo vuoi ancora perdere a fare a mano quello che puoi codificare. Un’infrastruttura scritta, versionata e leggibile non è solo più veloce da gestire: è più facile da capire, da migliorare, e da lasciare in eredità a chi verrà dopo di te.